テスト項目書を全部消化した夜、筆者はまだ画面をいじっていました。
筆者はAIとアプリを作るかたわら、実機での動作確認——テスターの仕事もしています(この成り行きは自己紹介のとおりです)。項目書に沿って一つずつ確認し、すべてに印が付いた。仕事としては、ここで終わりのはずです。
ところが、実機を長時間触っていると、妙なことをやりたくなってくるのです。
このボタン、連打したらどうなるんだろう。決済の処理中に、うっかり前の画面に戻りたくなったら? 単品で頼んだ商品を、セットでもう一回頼んでしまったら? 最初は出来心でした。でも、やってみると分かるのです。これは意地悪ではなく、数日後の実ユーザーが必ずやる操作だと。せっかちな人はボタンを二度押すし、注文の途中で気が変わる人もいるし、同じ商品を形を変えて頼む人も、絶対にいる。
——で、実際にやってみると、これが出るわ出るわ。項目書の上では健康優良児だったアプリが、項目書の外側で、次々と変な顔を見せるわけです。
どれだけ事前に想定を尽くしても、実機を長時間触ることで初めて「やりたくなる操作」がある。机の上の想像力と、手に持った端末の間には、確かな段差がありました。今日はこの段差の話から、AIプロダクトのテストの話へ進みます。
項目書の外側に、本番がある
まず、あの夜の発見を整理させてください。
テスト項目書は、事前の想像力の産物です。仕様書から「あるべき動き」を書き出し、確認していく。これは絶対に必要な仕事です。ただし項目書が守ってくれるのは、想像できた範囲だけです。
一方、本番のユーザーは想像の外側で生きています。電車が来たから操作を中断する。指がもつれて二度押す。家族に話しかけられて、どこまで進めたか忘れる。悪意ゼロの日常動作が、アプリにとっては「想定外の操作列」になる。筆者が実機で「やりたくなった」連打も出戻りも二重注文も、机上では思いつかなかったのに、手に端末があると自然に湧いてきました。あれはたぶん、長時間触るうちに、筆者の手が「本番のユーザーの手」に近づいていたのだと思います。
つまりユーザーテストとは、項目書の確認作業の追加ではなく、想像力の上限を、実際の人間の手で突破する工程なのです。
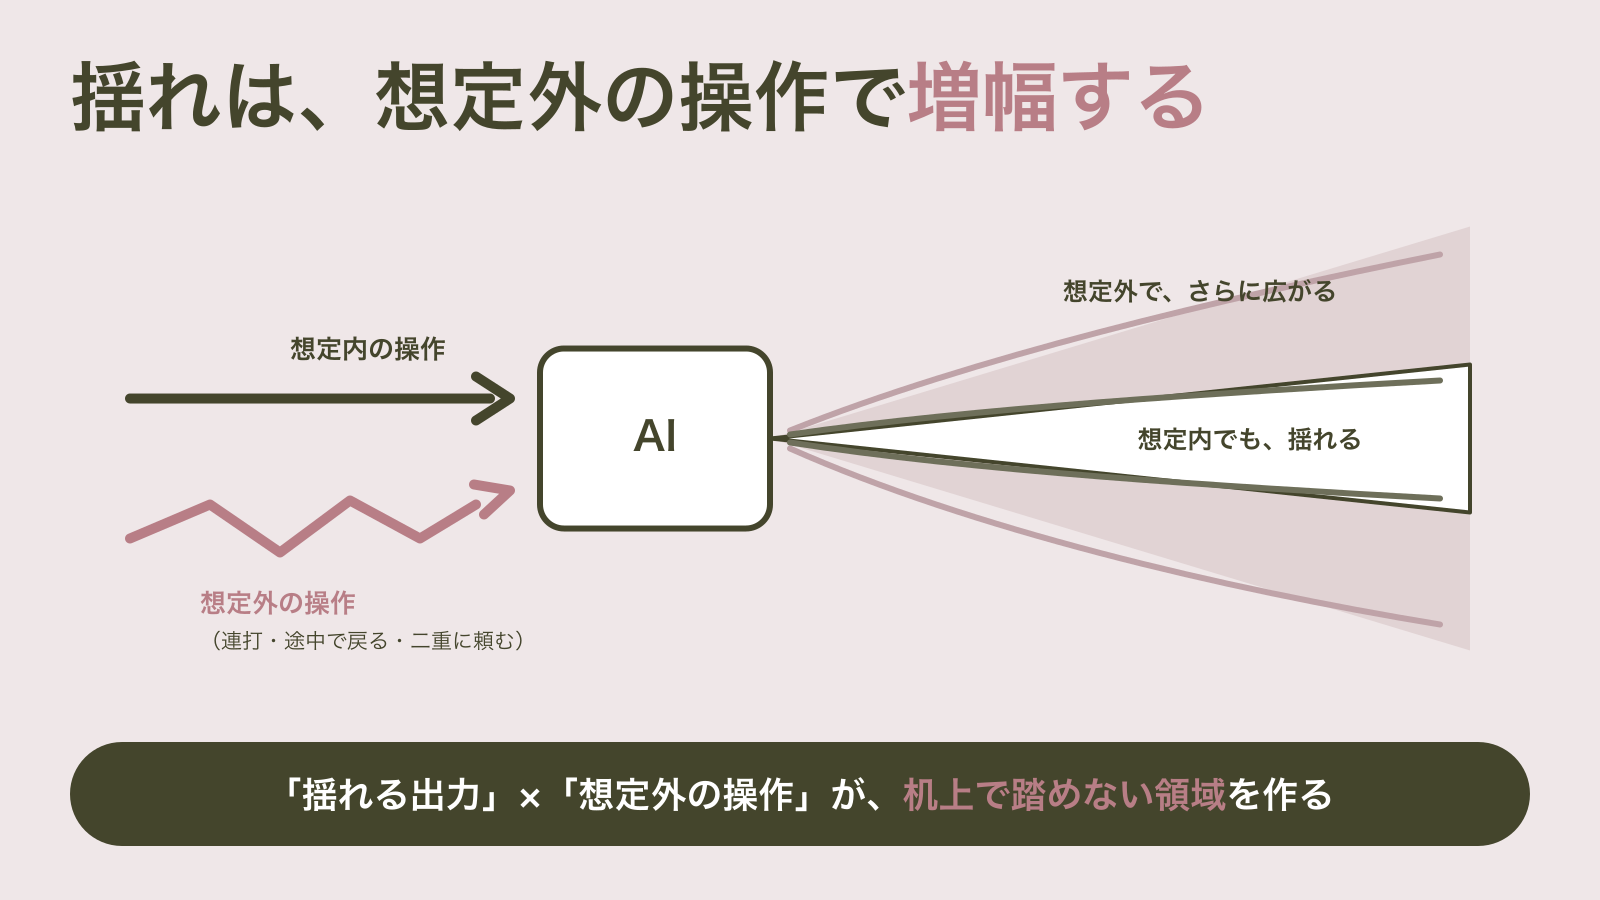
そしてこの工程の重要度は、テスト対象がAIプロダクトになると、さらに一段上がります。従来のソフトなら、想定の範囲さえ合っていれば挙動は安定していました。AIプロダクトは、想定の範囲内ですら出力が揺れる。「想像の外側の操作」と「揺れる出力」の掛け算が、机上のテストでは絶対に踏めない領域を作るからです。
「やりたくなる操作」から作るテスト ― AIプロダクトのユーザーテストとは・変わる5つの観点
ここで地図を広げます。とくに、テスト対象がAIプロダクトのとき、従来のテストと何が変わるのかを整理しておきます。
AIプロダクトのユーザーテストとは
実際のユーザー(に近い人)に、実際のタスクをAIプロダクト上でやってもらい、つまずき・誤解・信頼の変化を観察する検証活動です。画面の使いやすさ一般を確かめるユーザビリティテストの、AIプロダクト特化版と考えると据わりが良いです(一般的な手順・人数・手法はユーザビリティテストのやり方が詳しいので、本記事はAIで「変わる部分」に絞ります)。
なぜ従来のテストと違うのか
従来のソフトは、同じ入力に同じ出力が返ります。だから「この操作をしたら、この画面になること」という正解表と突き合わせる検証が成立しました。AIプロダクトは、同じ依頼でも出力が毎回同じとは限りません。正解表が作れない。この一点が、テストの観点を根本から変えます。
もうひとつ、入力側も変わります。ボタンは押し方が一通りですが、言葉は無限です。同じ用件でも、人によって頼み方の語彙も粒度もばらばらで、その全パターンを項目書に書き尽くすことは原理的にできません。だからこそ「実際の人に、実際の言葉で頼んでもらう」ことの価値が、従来のテストより大きくなります。
テスト環境の準備|本物のデータと本物の端末
観点の話の前に、環境の話をひとつ。テストは可能な限り、本物に近いデータと、実際の端末で行います。きれいなサンプルデータの上では、AIはきれいに動くものです。現実の、表記ゆれだらけの、抜けのあるデータを食わせたときの挙動こそが本番の挙動です。端末も同じで、開発機の大画面と、ユーザーの手の中のスマホでは、見えるもの・押しやすさ・通信の安定度が違います。筆者の「やりたくなる操作」も、実機を手に持っていたからこそ湧いてきました。
変わる5つの観点
| 観点 | 従来 | AIプロダクトでは |
|---|---|---|
| 1. 出力の評価 | 正解と一致するか | 妥当な範囲に収まるか・外れたとき何が起きるか |
| 2. 初回理解 | 操作が分かるか | 何を頼めるかが伝わるか |
| 3. 信頼の変化 | (ほぼ対象外) | 使うほど信頼が育つか・一度の誤りで崩れないか |
| 4. 誤りからの回復 | エラー処理の確認 | 気づけるか・直せるか・戻れるか |
| 5. 繰り返し使用 | 学習コスト | 2回目以降に速くなるか・飽きて使われなくなるか |
観点1|正解ではなく「妥当さ」と「外れ方」を見る
出力がぶれる前提では、1回の成功より、10回頼んだときの散らばり方が重要です。同じタスクを複数の参加者に、あるいは同じ参加者に複数回やってもらい、出力の幅を見る。とくに見るべきは外れた回です。ユーザーは外れに気づいたか。気づいたとき、どんな顔をしたか。「まあ、こんなもんか」と受け流したのか、「え、信用できない」と身を引いたのか。ここに信頼設計の宿題が全部出てきます。
観点2|「何を頼めるか」が伝わっているか
AIプロダクトの初回のつまずきは、操作方法より「頼み方」に出ます。参加者が白紙の入力欄の前で止まったら、それは参加者の問題ではなく、できることの提示の問題です(この構造はAIのUI/UXデザインで書いたとおりです)。観察のコツは、最初の1分間に口を出さないこと。ここで案内してしまうと、いちばん貴重な「初見の迷い方」のデータが消えます。
観点3|信頼の変化を時間軸で見る
1回のセッションの中でも、信頼は動きます。最初は疑って全部確かめていた参加者が、途中から確認せずに受け入れ始めるのか。逆に、一度の誤りで以降の出力を全部疑い始めるのか。この変化は、単発の成功率には決して出てこない情報です。「さっきは確認していたのに、いまは確認しませんでしたね。何か変わりましたか?」と、セッションの後で聞いてみると、信頼の動いた瞬間を本人の言葉で聞けます。
観点4|誤りからの回復を必ずテストに入れる
わざと誤答が出る状況を仕込んででも、「AIが間違えたとき」を観察します。参加者は誤りに気づけるか。直し方を見つけられるか。戻れるか。それとも、間違った出力をそのまま信じて次の作業へ進んでしまうか——実務ではこれがいちばん怖いシナリオです。AIプロダクトの命運は、正答時ではなく誤答時の体験で決まるからです。
観点5|2回目以降を見る
会話型の道具は、初回の感動と、2回目以降の面倒くささが同居しがちです。慣れたら速くなる道具か、毎回同じ手間がかかる道具か。可能なら日を空けて同じ参加者にもう一度使ってもらうと、定着の手触りが見えます。「初回はすごいと言っていたのに、2回目は開くのが億劫そう」——この落差が観察できたら、それは大発見です。
変わらないこと
観点は変わっても、土台は従来と同じです。実際のユーザーに近い人に、実際のタスクを、実際の環境でやってもらい、手と表情を観察する。作った本人の脳内デモでは代わりになりません。
進め方6ステップ
| ステップ | やること |
|---|---|
| 1. タスク設計 | 「◯◯を頼んで、結果を確認して、直す」まで含めた実タスクにする |
| 2. 参加者集め | 実ユーザーに近い人を少人数。身内だけで済ませない |
| 3. 実施 | 操作を教えず、考えを声に出してもらいながら観察 |
| 4. 意地悪の投入 | 後述の「意地悪の型」を混ぜ、想定外の挙動を見る |
| 5. 記録 | つまずき箇所・発話・表情・回復できたかを残す |
| 6. 直して再テスト | 1回で終えず、直しては小さく回す |
補足を2つ。ステップ1のタスクは「AIに◯◯を頼んでください」ではなく、「来週の会議の準備をする、という状況でこのツールを使ってください」のように、状況ごと渡します。頼み方まで指定してしまうと、いちばん見たい「頼み方の迷い」が消えるからです。ステップ3の「考えを声に出してもらう」は思考発話法と呼ばれる定番の手法で、画面録画だけでは分からない「なぜそこで止まったか」を拾えます。
誰に・何人・いつやるか
大人数は要りません。少人数でも、回数を重ねるほうが発見は増えます。1回目で見つかった大きなつまずきを直してから2回目をやらないと、2回目の参加者も全員同じ場所で転んで、その先の発見が得られないからです。参加者は「実ユーザーに近いが、開発の事情を知らない人」が理想で、社内でまかなうなら、せめて別部署の人にします。
作る前の仮説確認はユーザーインタビュー、作ったものの市場検証はMVP検証と、目的で使い分けます。ユーザーテストはその中間、「作ったものが人の手で使えるか」を確かめる位置です。
記録と評価のしかた
成功率の数字だけ残すのはもったいないです。どの発話で手が止まったか、AIの出力をどこまで読んだか、誤りに気づいた瞬間に何と言ったか。テストの価値の大半は、この生の観察に宿ります。録画と発話の記録を残し、チームで同じ場面を見られるようにしておきます。開発メンバーに生の映像を見てもらうのがいちばん効きます。レポートの「ユーザーは迷っていました」の一行と、実際に30秒固まっている映像では、チームの動き方が変わります。
AIの対話ログを、テスト資産にする
AIプロダクトには、従来のテストにない財産があります。対話ログです。参加者がどんな言葉で頼み、AIが何を返し、どこで言い直しが起きたか——全部残っている。言い直しが集中している箇所は「頼み方が伝わっていない」場所、セッションが途切れている箇所は「あきらめた」場所です。テスト後にログを読み返すだけで、観察のとり漏らしをかなり拾えます。
よくある失敗
台本どおりのデモをなぞらせて「テストした」と呼ぶ。開発チームの身内だけで済ませる。リリース前に1回だけやる。——どれも、テストを「儀式」にしてしまう失敗です。とくにAIプロダクトは出力がぶれるぶん、1回のきれいなデモは何の保証にもなりません。デモがうまくいくことと、現場で使い続けられることの間に深い谷があるのは、PoCの世界で散々語られてきたとおりで、ユーザーテストはその谷を、本番前に小さく安く踏んでおくための装置です。
もうひとつ付け加えるなら、「テストで見つかった問題を、直さない」も立派な失敗です。観察して、記録して、レポートにして、終わり。見つけた問題は直してこそのテストなので、最初から「直す時間」までをテスト計画に含めておきます。
——地図はここまで。最後に、明日から使える「意地悪」の話を。
明日から使える、意地悪の型
筆者が実機テストで体得した「やりたくなる操作」は、突き詰めると型に落とせます。ユーザーテストの参加者を集める前に、まず作り手が自分で試せる型です。所要時間は、ぜんぶ合わせても小一時間。あなたのプロダクトでも、そのまま試せるはずです。
連打する。 送信ボタン、決済ボタン、生成ボタン。二度押しで二重に処理が走らないか。見つかるのは、処理中にボタンを無効化していない箇所です。せっかちな指は、世界中にあります。
途中で戻る。 処理の真っ最中に、前の画面へ。中断されたアプリは、どんな状態で取り残されるか。中途半端に保存されたデータが、次回の起動時にどんな顔をして現れるか。
二重に頼む。 同じ依頼を、形を変えてもう一度。単品とセットのような「重なる注文」をどう扱うか。重複を検知して聞いてくれるのか、素知らぬ顔で両方受け付けるのか。
通信を切る。 電波の無いエレベーターやトンネルは日常です。途切れた瞬間の操作は保存されるのか、消えるのか、復帰したときに二重になるのか。機内モードのオンオフひとつで試せる、いちばん手軽な意地悪です。
曖昧に頼む。 AIプロダクトならこれを必ず。「いい感じにして」と頼んだとき、聞き返すのか、推測で突っ走るのか。突っ走った結果を、ユーザーは直せるのか。
一覧にしておきます。
| 意地悪 | 見つかる不具合の典型 |
|---|---|
| 連打する | 二重送信・二重決済・多重生成 |
| 途中で戻る | 中途半端な保存状態・次回起動時の不整合 |
| 二重に頼む | 重複データ・重なる注文の素通り |
| 通信を切る | 操作の消失・復帰時の二重反映 |
| 曖昧に頼む | 聞き返しなしの暴走・直せない推測結果 |
5つとも、悪意ではなく日常の再現です。電車は来るし、指はもつれるし、電波は切れる。そして5つとも、テスト項目書には書かれにくい。項目書は「正しく使ったら正しく動くこと」の確認に紙幅を使うものだからです。でも、本番のユーザーは正しく使ってくれるとは限らないし、正しく使えなかったユーザーのほうが、実は助けを必要としています。
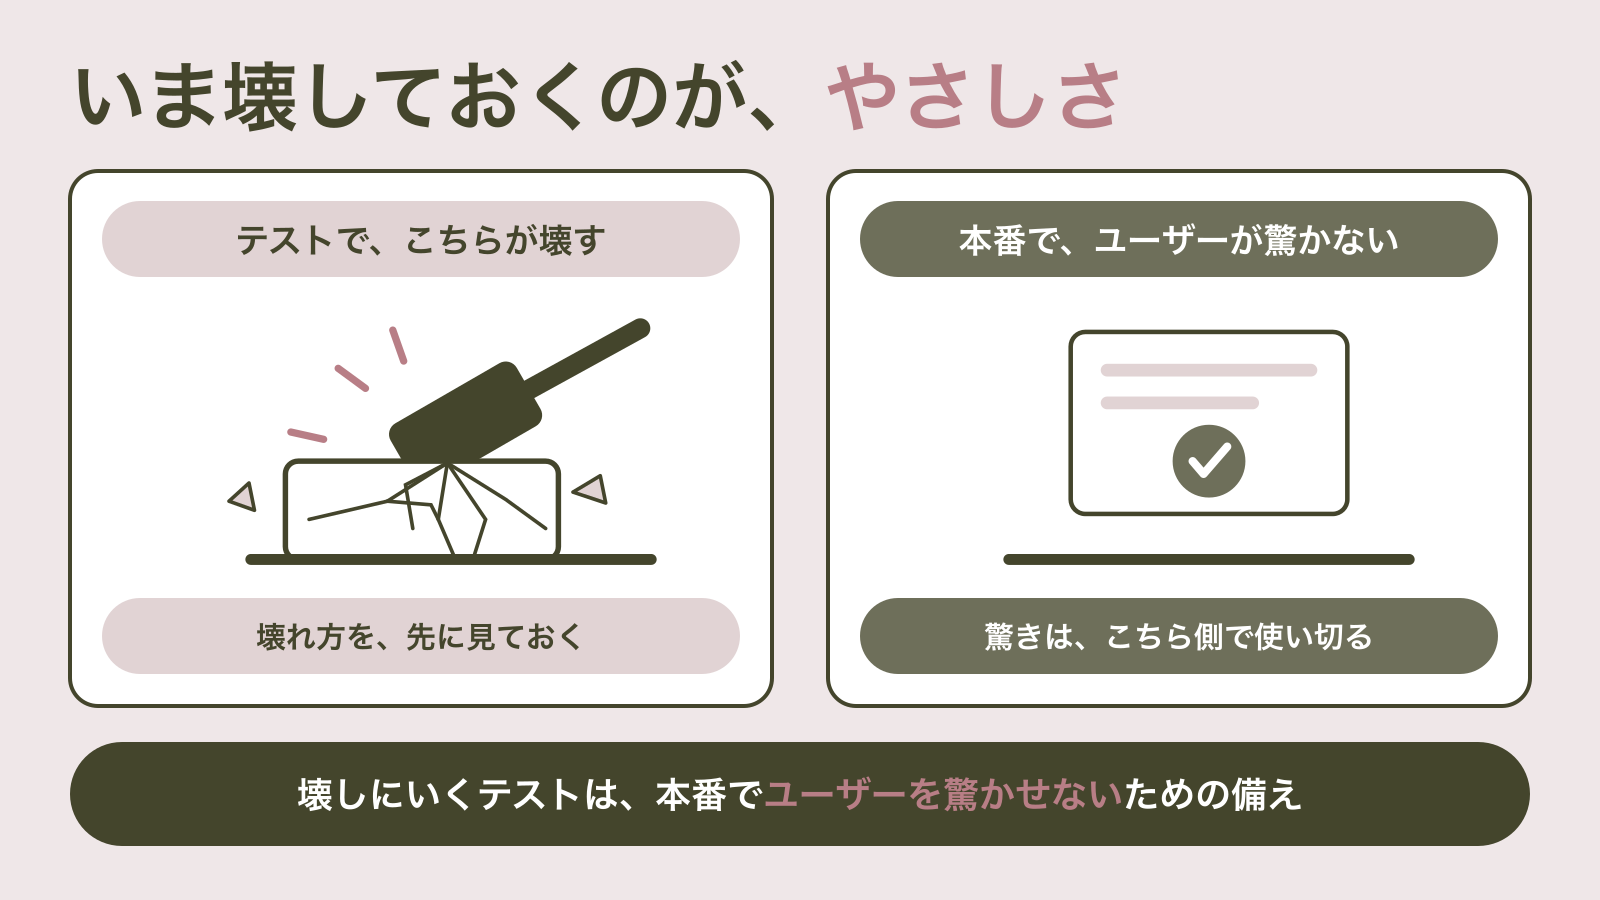
壊しにいくテストは、本番でユーザーを驚かせないための、いちばん確実なやさしさなんだと思います。
それで、あなたのプロダクトは——項目書の外側で、もう何回、触られましたか?
AIプロダクトのユーザーテストのよくある質問
AIプロダクトのユーザーテストとは何ですか?
実ユーザーに近い参加者に実際のタスクをやってもらい、つまずき・誤解・信頼の変化を観察する検証です。ユーザビリティテストのAIプロダクト特化版で、出力が毎回同じとは限らないため、正解との一致ではなく「妥当さ・外れたときの体験・信頼の変化」を見る点が従来と違います。テスト項目書による確認を置き換えるものではなく、項目書が守れない「想定の外側」を埋める役割です。
従来のユーザビリティテストと何が違いますか?
土台(実ユーザー・実タスク・観察)は同じです。違いは観点で、①正解表と突き合わせられない、②「何を頼めるか」の伝わり方が最初の関門になる、③信頼が時間とともに変化する、④誤りからの回復を必ず見る、⑤2回目以降の効率を見る、の5点です。一般的な手順や人数設計はユーザビリティテストの標準的な方法がそのまま使えます。
何人でやればよいですか?
少人数を複数回、が基本です。一度に大人数を集めるより、5人前後で実施→直す→また実施、の繰り返しのほうが発見が多く、AIプロダクトの出力のぶれも回数でカバーできます。人数を増やすより、参加者の顔ぶれを散らすほうが効きます。習熟度の高い人と初めての人、日常的にAIを使う人と使わない人では、つまずく場所がまるで違うからです。開発チームの身内だけで済ませないことが人数より重要です。
AIが間違えるケースは、どうテストすればよいですか?
誤答が出る状況を意図的に仕込み、参加者が誤りに気づけるか・直せるか・戻れるかを観察します。AIプロダクトの評価は正答時より誤答時の体験で決まるためです。気づけない誤りが多いなら、根拠表示や実行前確認など信頼まわりの設計課題として持ち帰ります。
テスト項目書によるテストは不要になりますか?
不要にはなりません。項目書は「あるべき動き」を保証する土台です。ただし項目書は想像できた範囲しか守れないため、実機を長時間触る探索的なテストと、本文の「意地悪の型」(連打・途中で戻る・二重に頼む・通信を切る・曖昧に頼む)を組み合わせて、想像の外側を埋めます。
いつの段階でやるべきですか?
理想は「直せるうちに、小さく何度も」です。仮説段階はユーザーインタビュー、プロトタイプができたらユーザーテスト、市場に出す判断はMVP検証と、段階ごとに目的の違う検証を使い分けます。リリース前に1回だけの儀式にしないことが、いちばんの分かれ目です。リリース後も、対話ログの言い直しや離脱の観察はそのまま続けられるので、テストは「開発の一工程」というより「運用の習慣」に近づけるのが理想です。
参加者には、何と伝えて協力してもらえばよいですか?
「あなたを試すテストではなく、道具を試すテストです」と最初に伝えます。参加者が操作に失敗するほど、道具の問題が見つかる——つまり失敗は歓迎だ、という空気を作ることが、率直な行動を引き出す一番の条件です。あわせて、困っても基本は助けないこと、思ったことを声に出してほしいこと、途中でやめても構わないことを伝えておくと、観察の質が安定します。
社内ツールでも、ここまでやる必要がありますか?
規模は小さくてよいので、やる価値があります。社内ツールは「使ってもらえないと意味がない」のに、業務命令で使わせられる分、不満が表に出にくく、静かに使われなくなるからです。別部署の2〜3人に触ってもらうだけでも、配る前に大きなつまずきは拾えます。道具を配っただけでは定着しない構図は、生成AIの社内導入で繰り返し観察されているとおりです。
この記事は、ARCHECOが運営するメディア「AI・新規事業戦略大学」でお届けしました。ARCHECOは、UI/UXデザインとプロダクト開発を強みに、お客さまと並走しながら「使われるもの」をつくっているチームです。ご相談・お問い合わせはこちらからどうぞ。

 AI・新規事業戦略大学


 Yasu

 Yuki Susai


