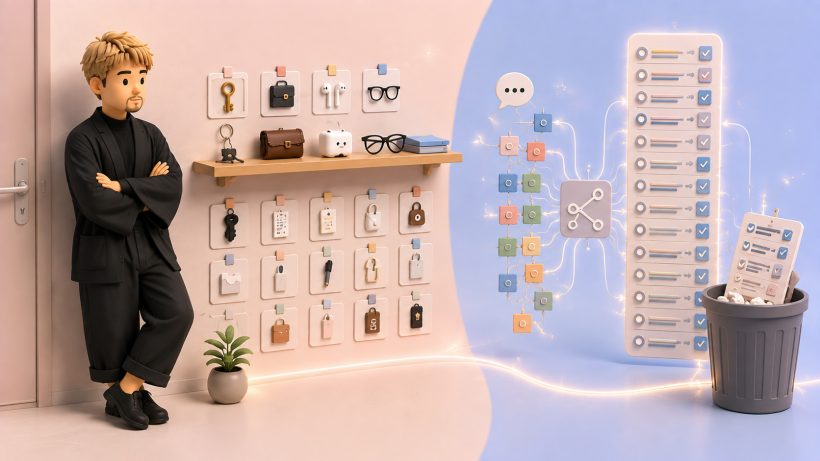


私はADHD(不注意や多動・衝動性に特徴がある発達障害)なので物をよく無くします。そこで玄関にラベルを貼りました。帰ってきたときに、手に持っているものをどこへ置くか、先に決めておきたかったからです。
鍵、財布、イヤホン、眼鏡拭き。棚のふちに、テープで4枚並べました。
ところが、実際に持って帰ってくるのは、そこに書いていないものばかりでした。傘、レシートの束、保育園からの紙、コンビニの袋。
そこでラベルを足しました。18枚になりました。それでも、置き場所が決まっているものは半分もありません。
同じような振り分けの問題は、AIを業務に組み込む場面でも起きます。AIエージェント(利用者の指示に応じて必要な処理を選び、実行する仕組み)を業務に組み込む会社が、ここ数年で一気に増えてきました。ただ、AIエージェントの作り方で最初に効いてくるのは、AIの中核となるモデルの選定でも、開発の土台となるフレームワークの選定でもありません。話しかけられた一文を、どの処理へ振り分けるかという、入り口の分岐です。
僕も、AIエージェントの入り口の分岐の作り方で失敗しました。採ったのは、来そうな言い回しを人が1本ずつ書き出し、文字列のパターンで入力を判定する正規表現というやり方です。分岐を27本並べ、34本まで増やし、最後にファイルごと消しています。
先に一行だけ置きます。AIエージェントを作るとき、利用者がどう話しかけてくるかを、人が想像で書き出してはいけません。 列挙できるのは、書いた人が思いつく言い方だけだからです。
今回話すプロジェクトは、水回りリフォームの現地調査アプリに、話しかけ欄を付けた
大企業と僕の会社の共創事業として、水回り専門のリフォーム会社が使う、現地調査アプリを立ち上げました。僕の会社は、その現地調査アプリを開発する役割です。最小限の機能だけを先に作って現場に出す、MVP(必要最小限の機能で価値を確かめる製品)という進め方です。扱うのは、戸建てのユニットバス、洗面台、トイレの入れ替えです。
現地調査は、調査担当が1人で客先へ行きます。浴室、洗面所、トイレの順に、寸法と配管の位置と既存の型番を、写真つきで記録していきます。1軒あたり40分から60分。その場で概算の見積を出して、帰る前に、工事を頼む家の持ち主に見せます。現場では、この人を施主と呼びます。
作ったのは、その調査アプリの下に置いた、話しかけ欄です。項目を順に選ばせるのをやめて、「次へ」でも「ユニットバスを一段下げて」でも、思ったことを一文だけ入れれば通る、という欄にしました。調査担当は、手が濡れていたり、しゃがんでいたりして、画面を細かく触れない時間が長いからです。
話しかけ欄に来る言葉は、3種類に割れます。画面を進める指示(「次の箇所へ進んで」「ここは飛ばして」)。いま見ている設備についての質問(「この給湯器、まだ部品って出ますか」)。そして見積のやり直し(「ユニットバス、ひとつ下のグレードで出し直して」)です。
今日は、その振り分けをどう作り、どこで失敗したか、という話をしていこうと思います。
前置きはさておき、本題に入ります。
① 教科書どおりに、正規表現で分岐を書いた


AIエージェントの作り方の基本をすでにご存じの方は、② 現場で使ってもらったら、見積のやり直しが一度も始まらないから読み進められます。
AIエージェントとは
AIエージェントとは、利用者から受け取った指示を読み、やるべき処理を自分で選んで実行する仕組みです。受け取った文をそのまま文章で返すだけの仕組みとは、ここが違います。
作る側から見ると、AIエージェントは「賢く返す機械」ではありません。入ってきた一文を、どの処理へ渡すかを決める振り分け機です。この記事の後半の話も、この一点から始まります。
AIエージェントの仕組み|モデル・道具・記憶の3つ
中身は、大きく3つの部品でできています。作り方の手順も、この3つを順に埋めていく形になります。
- モデル(LLM) — 入力を読み、何をすべきかを判断する部分
- 道具(ツール) — 実際に処理を行う関数やAPI。検索、計算、社内システムの呼び出しなど
- 記憶(メモリ) — 直前までのやりとりや、参照させたい資料を保持する部分
作り方でつまずくのは、たいてい「道具」の側です。モデルの選定は差し替えが効きますが、どの入力をどの道具に渡すかの決め方は、後から差し替えが効きません。
AIエージェントとチャットボット・RPAの違い
近い言葉が3つあります。違いは「誰が手順を決めるか」の一点です。
| 手順を決めるのは | 想定外の入力が来たら | |
|---|---|---|
| チャットボット | 人(シナリオを事前に書く) | シナリオに無い分岐は動かない |
| RPA | 人(画面操作を録画・記述する) | 画面が変わると止まる |
| AIエージェント | モデル(その場で選ぶ) | 選び直せる。ただし選び間違いが起きる |
「想定外に強い」ことと「間違えない」ことは別です。AIエージェントは前者を得ますが、後者は失います。だから作るときは、間違えたときに誰が気づくかを先に決めておく必要があります。
作る前に決めること1|自動化したい業務を洗い出す
まず、いま人がやっている作業を工程に割って並べます。そのうえで、「頻度が高い」「手順が決まっている」「間違いに気づける」の3つが揃う工程を探します。
実務では、3つ目が抜けがちです。頻度が高くて手順が決まっていても、出力が正しいかどうかを誰も確かめられない工程は、最初の対象にしないほうが安全です。
作る前に決めること2|対応する範囲を決める
「何でも聞ける」ものを最初に作ると、評価ができなくなります。受け付ける依頼の種類を、先に数えられる形にしてください。3種類なら3種類と決め、それ以外は「対応していません」と返す作りにします。
範囲を決めておくと、「拾えなかった入力」を後から数えられます。この数え方が、運用に入ってからいちばん効きます。
作る前に決めること3|開発方法を選ぶ(ノーコード・ローコード・フルコード)
作り方は3通りあります。選ぶ基準は、社内システムに繋ぐかどうかです。
- ノーコード(Difyなど) — 画面上で組む。試作と社内配布が速い
- ローコード(n8n・Flowiseなど) — 処理の流れを図で組み、一部だけコードを書く
- フルコード(Python+LangChainなど) — 既存システムへの接続や、細かい制御が要るとき
試作をノーコードで作り、本番はフルコードへ移すという進め方が実務では多いです。移すときに書き直すのは処理の中身であって、どの入力をどの処理へ渡すかの取り決めは、そのまま引き継げます。
開発ツールの選び方
見るべき点は4つです。機能の多さで選ぶと、後から詰まります。
- 社内システムに繋げるか — 認証の方式と、通信の経路
- ログが残るか — 入力・選ばれた処理・結果が、後から1件ずつ見られるか
- データの置き場所 — 入力がどこへ送られ、学習に使われないか
- 乗り換えられるか — 別のモデルへ差し替えたときに、作ったものがどこまで残るか
2つ目のログが、いちばん軽視されて、いちばん後で効きます。選び間違いは、ログが無いと「起きたこと」自体に気づけません。
作り方ステップ1|目的と使う場面を1つに絞る
「業務を効率化する」では作れません。誰が、どの場面で、何を打ち込み、何が返ってくれば成功かまで、1文で書けるところまで絞ります。
絞れているかどうかは、「失敗した」と言える条件を書けるかで分かります。書けないなら、まだ絞れていません。
作り方ステップ2|環境を用意する
選んだツールに登録し、使うモデルとAPIキーを設定します。ここで費用の上限(1日あたりの呼び出し回数など)も先に入れておくと、試行の途中で想定外の請求が立ちません。
作り方ステップ3|指示文(システムプロンプト)を設計する
モデルに渡す前提の文章です。役割、答えてよい範囲、答えられないときの返し方を書きます。
ここで、対応しない依頼が来たときの文言まで決めておいてください。決めていないと、モデルは範囲外の質問にも、それらしく答えてしまいます。
作り方ステップ4|ナレッジと道具(ツール)をつなぐ
参照させたい資料を登録し、実行させたい処理を道具として登録します。道具には、「いつ呼ぶか」を書いた説明文を付けます。
この説明文が、実質的な分岐そのものです。処理を増やすときに書き換えるのは、コードの条件分岐ではなく、この説明文になります。
作り方ステップ5|テストして公開する
動作確認は、作った本人が思いつく言い方だけでやらないでください。実際にその業務をしている人に、いつもの言い方で打ってもらいます。
確認するのは「答えが合っているか」だけではありません。どの道具が呼ばれたかを1件ずつ記録し、呼ばれるべき道具と突き合わせます。
作り方ステップ6|運用して、監視と改善を回す
公開後に見るのは3つです。
- どの道具が呼ばれたか(呼ばれるべきものと合っていたか)
- どの入力にも当たらなかったものは何件あったか
- 利用者が同じことを言い直した回数
3つ目が、いちばん早く異常を教えてくれます。言い直しが増えているとき、機能は動いていても、入り口の振り分けがずれています。
活用例1|問い合わせ対応の自動化
よくある質問への回答と、担当者への引き継ぎを分けます。引き継ぐ条件を先に決めておくのが要点です。「分からなければ人へ」ではなく、「この種類の質問は必ず人へ」と種類で決めると、運用が安定します。
活用例2|社内ナレッジの検索
社内の資料を参照して答えさせます。資料の更新日と出典を必ず返させてください。出典が無い答えは、正しくても業務では使えません。
活用例3|レポート・議事録の作成
録音や記録から要約を作ります。数字と固有名詞は、要約させずに原文から抜き出す形にすると、書き換えの事故が減ります。
注意点1|指示文が曖昧だと、精度は上がらない
「丁寧に答えて」のような指示は、判定に効きません。「どの場合にどの道具を呼ぶか」を、具体的な入力の例つきで書きます。
そして直したら、必ず同じ入力をもう一度流してください。片方を直すと、直していないほうの判定が下がることがあります。
注意点2|セキュリティとデータの扱い
決めておく項目は4つです。
- 入力した内容が、モデルの学習に使われない設定になっているか
- 個人情報・取引先名を送る必要が本当にあるか(送らずに済む形にできないか)
- 道具に渡す権限を、必要な範囲だけに絞っているか
- 入力と出力のログを、どこに、どれだけの期間、誰が見られる形で残すか
3つ目が抜けると、間違いが「起きた」だけで済まなくなります。書き込みや送信ができる道具は、確認の一段を挟むか、権限を読み取りだけにしてください。
注意点3|「すべてAIに任せる」設計の落とし穴
判断も実行も全部任せると、間違いに気づく人がいなくなります。答えが一つに決まる検査(数値が合うか、必須項目が埋まっているか)は、モデルに投げずにプログラムで確かめてください。
モデルに任せるのは、答えが一つに決まらない部分だけにします。
AIエージェントの費用の考え方
かかるのは3つです。モデルの利用料(呼び出し回数と文章量に比例)、ツールの利用料(月額が多い)、そして作る側と直す側の人件費です。
実務で効いてくるのは3つ目です。公開してからのほうが、直す回数は増えます。見積もるときは、作る工数だけでなく、直しを誰が引き取るかまで決めておいてください。
プログラミングができなくても作れるか
試作までは作れます。ノーコードのツールを使えば、資料を登録して指示文を書くところまでは、コードを書かずに進みます。
分かれ目は、社内システムに繋ぐかどうかと、判定を測るかどうかです。どちらも必要になった時点で、書ける人が要ります。
AIエージェントの作り方の教科書には、入り口の分岐について定石が書かれています。モデルを呼ばずに決められるものは、正規表現で即決する。 正規表現のほうが速く、安く、結果がぶれないからです。
素直にそのとおり書きました。
次へ進む言い方を6本。飛ばす言い方を6本。戻る言い方を3本。見積のやり直しを疑う言い方を12本。合わせて27本の正規表現を並べ、どれにも当たらなかったものは質問として扱う、という作りです。
この27本は、ちゃんと動きました。「次へ」と打てば次の箇所へ進み、「スキップ」と打てば飛びます。モデルを呼んでいないので、返りは一瞬です。
調査アプリを社内で見せたときも、問題は出ませんでした。この段階では、教科書が正しいと思っていました。
ここまでが、AIエージェントの作り方の教科書どおりの整理です。範囲を決め、道具をつなぎ、指示文を書き、測りながら直す。手順としては、これで合っています。
この記事の後半で扱うのは、その手順を守ったうえで起きたことです。入り口の分岐を、人が書き出した言い方で埋めていったときに、何が起きたか。
② 現場で使ってもらったら、見積のやり直しが一度も始まらない
ところが、調査アプリを実際の現場の調査担当に使ってもらうと、様子が変わりました。
見積のやり直しが、一度も始まりません。調査担当が話しかけ欄に打ち込んでも、見積は作り直されず、ただの返事が出るだけです。
最初に疑ったのは、見積を作り直す処理でした。呼ばれてから中で失敗しているのだろう、と考えたからです。
処理の記録であるログを開くと、そもそも呼ばれていませんでした。入り口の時点で、質問の経路に流れていました。
そこで、見積のやり直しを疑う言い方を12本から19本に増やしました。「プランを変えて」の語順違い、「別の候補を出して」の言い回し。そのうえで、遠回しな頼み方まで足しています。雨や暑さの話、疲れたという体調の話、もっと短くという時間の話。施主が横にいる場で「安くして」とは言いにくい。だから、そういう言い方で見積金額を下げてくれと頼んでくるのではないか、と考えました。分岐は全部で34本になりました。
それでも、見積のやり直しは始まりませんでした。
③ 気づいたのは、拾えなかった一行をログに出したとき

増やしても動かないので、増やす手をいったん止めました。
代わりに、どのパターンにも当たらなかった入力を、そのまま書き出す一行をログに足しました。当たったときはどのパターンに当たったかを、当たらなかったときは入力の頭から60字を残します。
半日ぶんのログを開いて、どのパターンにも当たらなかった入力だけを読みました。
並んでいたのは、次のような文です。「みつもりやりなおして」。「ユニットバスやめて」。「おまかせで」。
漢字が1文字も無い入力があります。設備の名前に否定形をくっつけただけの口語があります。何をしてほしいのか書いていない、丸投げの一言があります。34本のどれにも、かすりもしていませんでした。
ここではっきりしました。増やす方向が、そもそも間違っていました。
④ 原因を1件に絞る

AIエージェントの入り口の分岐の作り方がうまくいかなかった理由として思い当たることは、いくつもあります。テストに使った入力が綺麗すぎたこと、調査アプリを現場に出すのが遅かったこと、ログを最初から出していなかったこと。
ただ、原因を絞ると1件でした。
利用者がどう話しかけてくるかを、人が想像で書き出したこと。
列挙できるのは、書いた人が思いつく言い方だけです。ところが実際に来るのは、思いつかなかった言い方のほうです。27本でも34本でも、思いついた言い方しか列挙できないことに変わりはありません。数が足りなかったのではなく、列挙という方法が入り口に向いていませんでした。
⑤ 直したのは1箇所だけ

見積のやり直しの判定からだけ、正規表現を全部消しました。 19本が0本になっています。
代わりに、モデルが必要に応じて呼び出す「道具」を1つ渡しました。道具といっても実体は短い定義文で、「見積をやり直す」という名前と、呼ぶときに何を添えるかが書いてあるだけです。呼ぶかどうかは、モデルが決めます。呼べば見積の作り直しが走り、呼ばなければ普通の返事になります。
画面を進める指示の分岐は、そのまま残しました。「次へ」「スキップ」「戻る」は、言い方が有限だからです。
分岐のファイルは、81行から52行になりました。
この状態で同じ入力を流すと、「みつもりやりなおして」も「ユニットバスやめて」も「おまかせで」も、見積のやり直しとして拾われました。
⑥ あとで知った ── その渡し方には名前がついていました

しばらくして、ソフトウェアの設計について長く書いてきた Martin Fowler のサイトで、開発会社 Thoughtworks の技術者が寄せた実務記事を読み、手が止まりました。
Kiran Prakash が2025年5月に書いた、モデルに関数を呼ばせる話です。そこには、モデルは呼び出しを自分では実行せず、呼び出しの中身を説明するデータを作って、別のプログラムに渡すだけだ、と書かれていました。原文はこうです。「The LLM does not execute these calls directly, instead it creates a data structure that describes the call, passing that to a separate program for execution and further processing」。
僕が手探りでやったのは、まさにこれでした。名前は function calling、日本語では関数呼び出しと訳されています。同じ記事には、道具に付ける説明文が、その道具が何のためのものかをモデルに伝える、とも書かれていました。原文は「the description field provides extra context to help the LLM understand the function’s purpose」。
つまり、分岐は消えていませんでした。正規表現で書いていた判定条件を、道具の説明文に書くようになっただけです。
判定条件を道具の説明文に書くのなら、その説明文で正しく判定できるかどうかを確かめる方法が要ります。それも同じサイトにありました。Bharani Subramaniam と Martin Fowler が2025年2月に出した、生成AIのパターン集です。特定の仕事の文脈でモデルの応答を評価すること。それに Evals(評価)という名前が付いていました。原文は「Evaluate the responses of an LLM in the context of a specific task」です。
続けて書いてあるのは、Evalsでは結果を合格か不合格かの2択で見ない、ということです。合格とみなす基準値であるしきい値を置いて、前より下がっていないかを確かめる。 原文はこうです。「Unlike tests, they aren’t simple binary pass/fail results, instead we have to set thresholds, together with checks to ensure performance doesn’t decline」。
説明文は、書いて終わりではなく、測るものでした。新しい理屈は、ひとつも要りませんでした。
⑦ 変えてみて、何が良くなって、何を失ったか

正規表現を消してから22日後、画面を進めるために残していた15本——次へ6本、飛ばす6本、戻る3本——も消しました。分岐のファイルは、52行まるごと削除しています。
いま入り口にあるのは、モデルへ渡す道具が3つだけです。見積をやり直す、いま見ている設備について調べる、画面を進める。どれを呼ぶかは、毎回モデルが決めます。
ただ、代償があります。3件書いておきます。
1件目。「次へ」の一言でも、モデルを1回呼ぶようになりました。 正規表現なら待ち時間ゼロで返っていたところに、通信と生成の時間が乗ります。速さと安さを、判断の幅と交換した形です。
2件目。分岐は消えず、説明文へ移りました。 3つの道具に付けた説明文を数えると、合わせて1,391字あります。52行のファイルが、1,391字の散文に置き換わった形です。
そして道具を3つにしてから17日後、説明文による判定の誤りが見つかりました。「静かな給湯器ってないですか」という、調べてほしいだけの一言が、見積のやり直しへ流れていたのです。見積が丸ごと作り直され、関係のない設備が候補に混ざりました。
だから、説明文に境目を書き足しました。「見積をやり直す」は見積を作り直すとき専用で、近い製品のおすすめや在庫の質問は設備を調べる道具へ回す、と明記しています。
そのうえで、説明文に書き足した境目が効いたかどうかを、道具の選択結果で確かめました。現場から集めた入力を並べ、僕たち開発者が「これはこの道具を呼ぶ場面だ」と決めた正解(期待する振り分け)と、モデルが実際に選んだ道具が一致するかを数えました。比べる入力は、書き足したあとに現場から集まったぶんを足して、45件から54件に増やしています。一致は、45件中38件から、54件中54件になりました。 「静かな給湯器ってないですか」は5回中5回とも見積のやり直しに流れていたのが、6回中6回とも設備を調べる道具に振り分けられています。
3件目。利用者の一文だけでは、呼ぶ道具が決まらなくなりました。 「それも見積に入れて」と言われても、「それ」が何を指すのか分かりません。だから、会話の文脈として、直前のやり取りを毎回8件ぶん一緒に渡すようにしています。渡す量が増えれば、そのぶん費用も増えます。
⑧ 現場でAIエージェントを作るなら、この順番

入り口の分岐を決めるときに使っているのは、次の3つの問いです。
1. 言い方が有限か。ボタンの文言や決まった合図のように言い方が数えられるなら、正規表現で即決します。数えられないなら、モデルへ道具として渡します。
2. 間違えても誰かが気づくか。画面に出るなど、間違いが目に触れるなら、そのまま任せます。黙って進むなら、人が確かめる一段を挟みます。
3. 説明文を直したあと、測れるか。測れるなら進めてよい。測れないなら、先に入力の一覧を作ります。
いちばん効くのは、3つ目の問いです。説明文は、人が普段使う言葉で書く自然言語なので、ある道具の説明文を直しただけで、説明文を直していない道具が選ばれるかどうかまで変わります。 45件中38件だった一致が54件中54件になった一方で、書き足し方を誤れば逆へも同じだけ動きます。
だから、AIエージェントを作る順番は次の4件になります。
1件目、入り口の分岐を1つだけ選ぶ。全部を一度に道具へ移さない。
2件目、その分岐に来る入力を、実際に動いているアプリのログから集める。「みつもりやりなおして」は、机の上では出てきません。
3件目、道具の説明文を書き、集めた入力を流して、どの道具が選ばれたかを数える。ここで初めて、説明文が良いか悪いかを言えます。
4件目、説明文を直したら、同じ入力をもう一度流して、下がった項目が無いかを見る。合格と不合格ではなく、前回の数字と比べます。
この4件は、扱っているものには依存しません。浴室でも、部品でも、契約書でも同じです。
⑨ この作り方が効き続ける理由

モデルが賢くなっても、この順番は変わらないと考えています。
話しかけ方を決めているのは、モデルではなく利用者だからです。日本語を話す人の数だけ言い方があり、そこには漢字を打たない人も、否定形で頼む人も、丸投げする人もいます。列挙が追いつかないのは、モデルの性能の問題ではありません。27本を34本に増やしたときと同じことが、モデルを新しくしても起きます。
一方で、道具の説明文の効き方は、モデルを乗り換えると変わります。同じ説明文を渡しても、道具の選ばれ方が動きます。だから資産になるのは説明文そのものではなく、説明文を測るための入力の一覧のほうです。その一覧を1本作っておけば、乗り換えるたびに使い回せます。
この入り口の設計を実際の業務に落とす話は、AIエージェント開発のページに整理しています。作りかけのAIエージェントで、どこまでを正規表現で決めるか迷っている工程があれば、こちらからご相談ください。
玄関のラベルは、18枚とも剥がしました。棚に置いたのは、いちばん大きいカゴを1つだけです。
代わりに、カゴの横へ紙を貼りました。何を入れていいかを書いた紙です。
いま貼っているのは3枚目の紙で、いちばん下の行に「傘はここに入れない」と書き足したところです。
以上です。
▶ この記事のテーマを実務で相談する: AIエージェント開発
AIエージェントの作り方のよくある質問
AIエージェントの作り方は、どんな手順になりますか?
6ステップです。目的と使う場面を1つに絞る、環境を用意する、指示文(システムプロンプト)を設計する、ナレッジと道具(ツール)をつなぐ、テストして公開する、運用して監視と改善を回す。この手前に、自動化する業務の洗い出し、対応する範囲の決定、開発方法(ノーコード・ローコード・フルコード)の選択という3つの準備があります。
AIエージェントとチャットボット・RPAは何が違いますか?
手順を誰が決めるかが違います。チャットボットは人がシナリオを事前に書き、RPAは人が画面操作を記述します。AIエージェントはモデルがその場で処理を選びます。そのぶん想定外の入力に強くなりますが、選び間違いが起きます。想定外に強いことと間違えないことは別なので、間違えたときに誰が気づくかを先に決めておく必要があります。
プログラミングができなくてもAIエージェントは作れますか?
試作までは作れます。ノーコードのツールを使えば、資料を登録して指示文を書くところまではコードを書かずに進みます。分かれ目は、社内システムに繋ぐかどうかと、判定の正しさを測るかどうかです。どちらかが必要になった時点で、コードを書ける人が要ります。
AIエージェントの作成・運用には、どのくらい費用がかかりますか?
かかるのは3つです。モデルの利用料(呼び出し回数と文章量に比例)、ツールの利用料(月額が多い)、そして作る側と直す側の人件費です。実務で効いてくるのは3つ目で、公開してからのほうが直す回数は増えます。見積もるときは、作る工数だけでなく、直しを誰が引き取るかまで決めておいてください。
AIエージェントを作るとき、注意すべき点は何ですか?
3つあります。指示文が曖昧だと精度は上がらないので、どの場合にどの道具を呼ぶかを具体的な入力の例つきで書くこと。入力が学習に使われない設定、権限の範囲、ログの保存先を先に決めること。そして、すべてをAIに任せないこと。答えが一つに決まる検査はプログラムで確かめ、モデルに任せるのは答えが一つに決まらない部分だけにします。
AIエージェントの作り方で、最初に設計すべきことは何ですか?
最初に設計すべきなのは、利用者から来た一文をどの処理へ振り分けるかという入り口の分岐です。まず分岐を1つだけ選び、そこに来る入力を実際に動いているアプリのログから集めます。次に道具の説明文を書き、集めた入力を流して、モデルがどの道具を選んだかを数えます。説明文を直したら同じ入力をもう一度流し、前回より下がった項目がないかを確認します。
AIエージェントの分岐を正規表現で作ると、なぜ失敗するのですか?
利用者の言い回しを人が想像で列挙すると、書いた人が思いついた表現しか拾えないからです。記事の事例では正規表現を27本から34本へ増やしても、見積のやり直しは一度も始まりませんでした。実際の入力には、漢字のない文、設備名に否定形を付けただけの口語、何をしてほしいかを書かない一言がありました。数が足りないのではなく、言い方が有限でない入り口に列挙という方法が向いていませんでした。
正規表現とモデルによる判定は、どう使い分けますか?
ボタンの文言や決まった合図のように言い方が有限なら、正規表現で即決できます。言い方が有限でないなら、処理を道具としてモデルへ渡し、どれを呼ぶか選ばせます。間違いに誰も気づけない処理では、人が確かめる一段を挟みます。説明文を直したあとに測れない場合は、先に評価用の入力一覧を作ります。
AIエージェントのfunction callingとは何ですか?
function callingは、モデルに関数を呼ばせる仕組みで、日本語では関数呼び出しと訳されます。モデル自身が呼び出しを実行するのではなく、呼び出しの内容を表すデータを作り、別のプログラムへ渡します。道具に付けた説明文が、その道具の目的をモデルへ伝えます。そのため、従来の分岐は消えるのではなく、正規表現から道具の説明文へ移ります。
道具の説明文はどのように評価しますか?
現場のログから入力を集め、それぞれについて呼ぶべき道具を正解として決めます。その入力をモデルへ流し、実際に選ばれた道具と正解が一致するかを数えます。評価は単純な合格・不合格ではなく、しきい値を置き、前回より性能が下がっていないかを確認します。説明文を変更したら同じ入力でもう一度測り、直していない側の判定まで動いていないかを見ます。
AIエージェントの分岐をモデルに任せるデメリットは何ですか?
短い指示でもモデルを呼ぶため、正規表現より待ち時間と費用が増えます。また、分岐の条件は消えず、道具の説明文として管理する必要があります。一文だけで対象が分からない場合は直前のやり取りも渡すため、入力する情報量と費用がさらに増えます。説明文の境目が曖昧だと、調べるだけの依頼が見積のやり直しへ流れるような誤判定も起こります。
- 今回話すプロジェクトは、水回りリフォームの現地調査アプリに、話しかけ欄を付けた
- ① 教科書どおりに、正規表現で分岐を書いた
- AIエージェントとは
- AIエージェントの仕組み|モデル・道具・記憶の3つ
- AIエージェントとチャットボット・RPAの違い
- 作る前に決めること1|自動化したい業務を洗い出す
- 作る前に決めること2|対応する範囲を決める
- 作る前に決めること3|開発方法を選ぶ(ノーコード・ローコード・フルコード)
- 開発ツールの選び方
- 作り方ステップ1|目的と使う場面を1つに絞る
- 作り方ステップ2|環境を用意する
- 作り方ステップ3|指示文(システムプロンプト)を設計する
- 作り方ステップ4|ナレッジと道具(ツール)をつなぐ
- 作り方ステップ5|テストして公開する
- 作り方ステップ6|運用して、監視と改善を回す
- 活用例1|問い合わせ対応の自動化
- 活用例2|社内ナレッジの検索
- 活用例3|レポート・議事録の作成
- 注意点1|指示文が曖昧だと、精度は上がらない
- 注意点2|セキュリティとデータの扱い
- 注意点3|「すべてAIに任せる」設計の落とし穴
- AIエージェントの費用の考え方
- プログラミングができなくても作れるか
- ② 現場で使ってもらったら、見積のやり直しが一度も始まらない
- ③ 気づいたのは、拾えなかった一行をログに出したとき
- ④ 原因を1件に絞る
- ⑤ 直したのは1箇所だけ
- ⑥ あとで知った ── その渡し方には名前がついていました
- ⑦ 変えてみて、何が良くなって、何を失ったか
- ⑧ 現場でAIエージェントを作るなら、この順番
- ⑨ この作り方が効き続ける理由
- AIエージェントの作り方のよくある質問
- AIエージェントの作り方は、どんな手順になりますか?
- AIエージェントとチャットボット・RPAは何が違いますか?
- プログラミングができなくてもAIエージェントは作れますか?
- AIエージェントの作成・運用には、どのくらい費用がかかりますか?
- AIエージェントを作るとき、注意すべき点は何ですか?
- AIエージェントの作り方で、最初に設計すべきことは何ですか?
- AIエージェントの分岐を正規表現で作ると、なぜ失敗するのですか?
- 正規表現とモデルによる判定は、どう使い分けますか?
- AIエージェントのfunction callingとは何ですか?
- 道具の説明文はどのように評価しますか?
- AIエージェントの分岐をモデルに任せるデメリットは何ですか?


 柳田恒平

 AI・新規事業戦略大学

 Yasu


 Yuki Susai