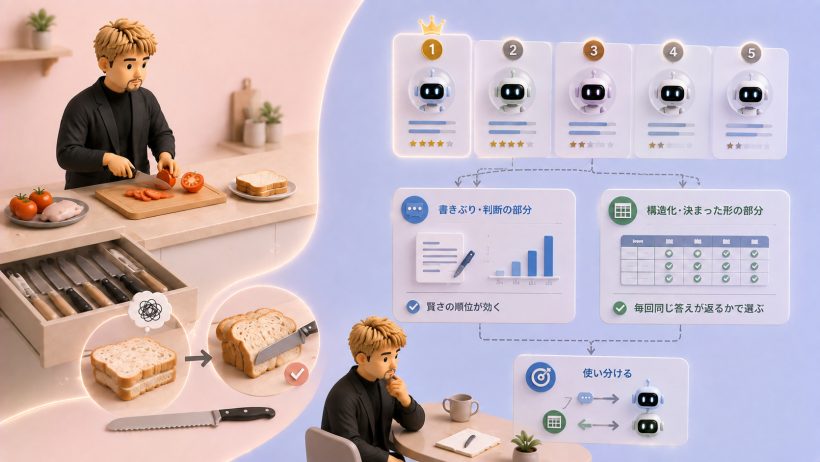


三年ほど前に、よく切れる包丁を1本だけ買いました。(僕の学生時代のアルバイト先の先輩が研師になって僕のために見繕ってくれました。)それまで台所にあった刃物は、ぜんぶ引き出しの奥にしまいました。1本あれば足りると思ったからです。
トマトも、鶏肉も、食パンも、その1本で切りました。トマトと鶏肉は、驚くほどきれいに切れます。
ところが食パンだけは、切るたびに断面が潰れます。パンの厚みがわかりづらくなり、均等な厚みに切れなくなりました。
結局、パン用のギザギザした包丁を、あとから買い足しています。よく切れることと、パンがいつも同じ厚さで切れることは、別のことでした。
ここ数年、大規模言語モデル(LLM。大量の文章を学習し、文章の生成や情報の整理を行うAI)の新しい型番(モデルの世代や種類を区別する名称)が、数か月おきに出るようになりました。どれを選ぶかで結果が変わると言われ、LLMの比較表もたくさん公開されています。表を読むと、たいてい賢い順にモデルが並んでいます。
僕も、その表の一番上を選びました。そして、文章を書かせる処理にも、決まった形で値を取り出す処理にも、同じ1つのモデルを使い、モデルの選び方に失敗しました。
先に一行だけ置きます。LLMを比較するとき、賢さの順位だけで選ぶと失敗します。 賢さの順位が効くのは、書きぶりと判断の部分だけです。一方、決まった形で返してほしいところでは、毎回同じ答えが返るかどうかを基準にモデルを選びます。
今日は、LLMを比較する軸を、賢さから何に変えたのか、という話をしていこうと思います。
前置きはさておき、本題に入ります。
この話に出てくる事業
大企業と僕の会社が共同で、最小構成(必要な機能だけを備えた形)で試すところまで立ち上げた事業がいくつかあります。そのひとつが、医療機関向けに白衣とリネンをレンタルする事業の、問い合わせ受付です。この事業で、僕の会社は問い合わせ受付の仕組みを開発する役割です。病院とクリニックに白衣・シーツ・バスタオルを貸し出し、週2回、汚れたものを回収して洗って納品します。
問い合わせは、看護部長や事務長からメールで届きます。「白衣のサイズをMからLに交換したい」。「今週の回収を木曜から金曜にずらしてほしい」。「大判のバスタオルが3枚足りない」。受付に届くメールは、1日に40件前後あります。
受けているのは、営業事務の担当者が2名です。担当者は、届いたメールを読んで、社内の管理表に品目と枚数と日付を打ち込み、それから返信を書きます。
この問い合わせの一次返信(問い合わせに対して最初に返す返信)を、LLMに任せることにしました。任せたのは、次の3件の処理です。返信の文面を書くこと。メールから「どの施設の、どの品目を、何枚、いつ」を決まった形で抜き出すこと。そして送り主が書いた品名を、社内の品目名に寄せることです。
3件目だけ、少し説明が要ります。同じ品物が、送り主によって「大判のバスタオル」とも「浴用タオル」とも「BT」とも書かれてきます。この表記のゆれを、社内で使っている1つの品目名に寄せる処理です。
① 教科書どおりに、比較表の一番上のモデルを選んだ


LLMの比較の基本をすでにご存じの方は、② 同じメールを3回投げると、3回とも違う形で返ってきたから読み進められます。
先に、LLMの比較を教科書どおりに整理しておきます。どんな種類があり、どの軸で比べ、目的別にどれを選ぶのか。
LLM(大規模言語モデル)とは
LLMとは、大量の文章を学習し、次に来る言葉を推定することで文章を組み立てるモデルです。Large Language Model の頭文字を取っています。
比較の話をする前に押さえておくべきことが1つあります。LLMは「知っていることを取り出す装置」ではなく、「もっともらしい続きを組み立てる装置」です。後で出てくる注意点は、ほぼすべてこの性質から派生します。
LLMと生成AI・自然言語処理(NLP)の違い
生成AIとの違いは、含む・含まれるの関係です。言葉が近いため比較表で混ざりやすい3語を、先に分けておきます。
| 指しているもの | 関係 | |
|---|---|---|
| 生成AI | 文章・画像・音声・動画などを作るAIの総称 | LLMを含む、より広い言葉 |
| LLM | そのうち、言語を扱う大規模なモデル | 生成AIの一部 |
| 自然言語処理(NLP) | 言語を機械で扱う技術分野そのもの | LLMはNLPを実現する手段の1つ |
製品を比較するとき、この3つが同じ表に混ざっていないか確認してください。「生成AIツール」の比較表に、モデルとアプリケーションが並んでいることがあります。買う対象が違うので、料金の単位も揃いません。
クローズドモデルとオープンウェイトモデルの違い
| 中身の公開 | 使い方 | 向いているとき | |
|---|---|---|---|
| クローズド(商用API) | 非公開 | APIを呼ぶ | すぐ始めたい。運用を持ちたくない |
| オープンウェイト | 重みが公開 | 自社の環境で動かせる | 自社で抱えたい。外に出せないデータがある |
「オープンソース」と「オープンウェイト」は別物です。学習データや学習手順まで公開されているものがオープンソース、学習済みの重みだけが配られているものがオープンウェイトです。公開されているモデルの多くは後者で、ライセンスに商用利用の条件が付いていることがあります。
クラウドLLMとローカルLLMの違い
| データの出先 | 費用の出方 | 弱いところ | |
|---|---|---|---|
| クラウドLLM | 外部のサービス | 使った量に応じた従量 | データを外に出せない業務では使えない |
| ローカルLLM | 自社の環境から出ない | 機材と運用の固定費 | 止まったときに直すのは自社 |
ローカルLLMを「無料」と読むと、判断を誤ります。モデルの利用料は掛かりませんが、機材、電力、更新作業、動かなくなったときの切り分けが自社の負担になります。件数が少ないうちは、クラウドのほうが安く付きます。
主要LLMの比較表|系統ごとの傾向
個々の版は数か月で入れ替わるため、系統ごとの傾向で並べます。版ごとの数値は、後述するベンチマークの一覧で確認してください。
| 系統 | 提供の形 | 傾向として強い領域 |
|---|---|---|
| GPT系(OpenAI) | 商用API | 用途の幅が広い。周辺の道具が揃っている |
| Claude系(Anthropic) | 商用API | 長い文章の読み取りと、自然な日本語 |
| Gemini系(Google) | 商用API | 画像や音声を含む入力。Googleのサービスとの連携 |
| Llama系(Meta) | オープンウェイト | 自社環境での運用。改造しやすい |
| Mistral系 | オープンウェイト | 軽さと性能の釣り合い |
| Qwen系(Alibaba) | オープンウェイト | 多言語とコード生成 |
| DeepSeek系 | オープンウェイト/API | 費用の安さとコード領域 |
| Command系(Cohere) | 商用API | 社内文書を参照させる用途(RAG) |
| 国産(tsuzumi・ELYZA・Swallowなど) | API/オープンウェイト | 日本語と、国内での提供体制 |
この表だけで選ばないでください。傾向は毎回の更新で入れ替わります。選定に使えるのは、自社の実際の入力で試した結果だけです。次の比較軸は、その試し方の設計図として読んでください。
ベンチマークとリーダーボードの読み方
公開されている順位表(リーダーボード)や日本語の評価用データセットで、各モデルの成績を確認できます。
ただし、順位表の上位が自社の業務で最良とは限りません。評価に使われている課題と、自社の業務が違うためです。順位表は候補を3つに絞るまでに使い、最後は自社の入力20件で比べてください。
LLMを比較する10の軸
| 軸 | 確かめること | 手を抜くと |
|---|---|---|
| 1. 精度・回答品質 | 自社の入力で、期待する形の答えが返るか | 実演の題材でしか合わない |
| 2. コンテキスト長 | 一度に渡せる文章の量 | 長い資料が途中で切れ、後半が無視される |
| 3. 得意分野 | 文章生成・分析・コードのどれに寄っているか | 不得意な領域を、指示文で埋めようとして消耗する |
| 4. 料金・コスト | 入力と出力それぞれの単価、月額の下限 | 出力側の単価を見落とす |
| 5. 処理速度 | 応答が返るまでの時間 | 画面の裏で待たされ、業務の流れが止まる |
| 6. セキュリティ・企業利用 | 入力データの学習利用、保存先、監査ログ | 社外に出せないデータが流れる |
| 7. 運用・連携のしやすさ | 使っている業務ソフトやSDKとつなげるか | 接続の開発費が別に発生する |
| 8. 日本語対応 | 日本語で使えるか、日本語に特化しているか | 「対応」と「特化」を同じものとして比べてしまう |
| 9. 商用利用の可否 | ライセンスの条件と、再配布の可否 | 本番に載せる直前に使えないと分かる |
| 10. 要求スペック | ローカルで動かす場合のGPUメモリと台数 | 検証機では動くが、本番の規模で動かない |
4番目の落とし穴を補足します。料金は入力と出力で単価が違い、出力側のほうが高いのが普通です。要約のように「長く入れて短く出す」用途と、文章生成のように「短く入れて長く出す」用途では、同じモデルでも月額が逆転します。
8番目も、比較表で最も混ざるところです。日本語で入出力できることと、日本語の言い回しや国内の制度に強いことは、別々に確かめてください。
目的別の選び方①|文章生成・コンテンツ制作
文体の自然さと、長い文章を破綻させずに書き切れるかで選びます。出力が長くなるため、出力側の単価が効きます。同じ品質なら、単価の低い系統に寄せる余地があります。
目的別の選び方②|業務効率化・社内活用
要約、整形、分類のような定型処理が中心になります。ここで効くのは賢さより、毎回同じ形式で返ってくることと、応答が速いことです。
上位のモデルを選ぶ必要が無い領域でもあります。軽いモデルで足りるなら、費用と速度の両方が改善します。
目的別の選び方③|開発・コード生成
コードの生成と修正では、長いコードを一度に読める量(コンテキスト長)が効きます。既存のコードを渡せないと、文脈に合わない実装が返ってきます。
目的別の選び方④|RAG(社内文書を参照させる)
渡した資料の中から答えを組み立てる用途です。ここで見るのは知識量ではなく、「渡した資料に無いことを、無いと答えられるか」です。
賢いモデルほど、資料に無いことを補って答えてしまう場面があります。検証は、わざと資料に無いことを聞いて確かめてください。
目的別の選び方⑤|機密情報を扱う・社外に出せない
データを外に出せない業務では、ローカルLLMか、国内提供の閉じた環境が候補になります。
この選択は、性能ではなく制約で決まります。性能表を先に見ると、使えない候補に時間を使うことになります。制約から絞り、その中で比べてください。
ファインチューニングは必要か
ファインチューニングとは、既存のモデルに自社のデータを追加で学習させ、振る舞いを寄せることです。
多くの用途では、先に試すべきなのは指示文の作り込みと、社内文書を参照させる仕組み(RAG)です。ファインチューニングは費用と手間がかかり、モデルが更新されるたびにやり直しになります。文体や出力形式を固定したい場合に限って検討してください。
注意点①|最新モデルが、必ず最適とは限らない
新しいモデルは、多くの評価で成績が上がります。ただし単価が高い、応答が遅い、出力の癖が変わっていることがあります。
更新のたびに、これまで動いていた処理の出力が変わる場合があります。業務に載せているなら、使うモデルの版を固定できるかどうかを、契約の段階で確認してください。
注意点②|ローカルLLMは運用コストまで含めて考える
- GPUを含む機材の購入または借用
- 電力と設置場所
- モデルの更新と、動作確認のやり直し
- 動かなくなったときに切り分けられる人
4つ目が確保できないなら、ローカルは選ばないでください。止まった日に、業務ごと止まります。
注意点③|ハルシネーションと出力の正確性
もっともらしい誤りを、自信のある文体で出します。どのモデルでも起きます。程度の差でしかありません。
対策は、根拠を渡すこと、「渡した資料に無い場合は無いと答える」と指示に書くこと、そして誤りが外に出る手前に人を置くことです。
注意点④|機密情報の取り扱い
- 入力したデータが学習に使われない設定になっているか
- データの保管される国と、保存期間
- 監査のためのログが取れるか
- 再委託先(推論を別の事業者が担っていないか)
4つ目は見落とされがちです。契約している相手と、実際に推論している事業者が違う場合があります。
比較の前に立ちはだかる、組織側の壁
- 現場のAIリテラシー不足 — 導入したが使い方が分からず形骸化する
- 業務プロセスが前提になっていない — 仕事の流れの中に置き場が無く、片手間の道具で終わる
- 局所的な効率化で止まる — 担当者1人が速くなっただけで、全体の処理量は変わらない
3つ目は、モデルを替えても解決しません。どのモデルを選ぶかより、どの工程に置くかのほうが、結果への影響は大きくなります。
LLM比較のよくある質問
Q. LLMは、どれが一番優秀ですか。
用途によって変わるため、単一の順位は付きません。長文の読み取り、コード生成、費用の安さ、日本語の自然さは、それぞれ強い系統が違います。順位表で3つに絞り、自社の入力20件で比べてください。
Q. 企業で使うなら、どのLLMがおすすめですか。
まず制約から絞ります。外に出せないデータがあるならローカルか国内提供の閉じた環境、無いなら商用APIです。そのうえで、入力データが学習に使われない設定・監査ログ・版を固定できるかの3点を確認してください。
Q. LLMの比較で、いちばん見落とされる項目は何ですか。
料金の出力側の単価と、オープンウェイトモデルの商用利用の条件です。前者は用途によって月額が逆転し、後者は本番に載せる直前に発覚すると手戻りになります。
Q. ローカルLLMとクラウドLLMは、どちらを選ぶべきですか。
データを外に出せるかどうかで決まります。出せるならクラウドのほうが、件数が少ないうちは安く付きます。ローカルは、動かなくなったときに切り分けられる人が社内にいる場合にだけ選んでください。
Q. ファインチューニングは必要ですか。
多くの用途では不要です。先に試すのは、指示文の作り込みと、社内文書を参照させる仕組みです。ファインチューニングはモデルが更新されるたびにやり直しになるため、文体や出力形式を固定したい場合に限って検討します。
Q. オープンソースLLMとオープンウェイトLLMは何が違いますか。
学習データや学習手順まで公開されているのがオープンソース、学習済みの重みだけが配られているのがオープンウェイトです。公開モデルの多くは後者で、ライセンスに商用利用の条件が付くことがあります。
モデルの選び方は、素直に教科書どおりにしました。
公開されているLLMの比較表を3件ならべて、共通して上位にいるモデルを1つ選びます。そして、返信の文面も、項目の抽出も、品名を寄せる処理も、全部そのモデルに投げました。ここでいう「投げる」は、データを入力して処理させることです。1つの賢いモデルで足りるなら、切り替えの手間もかかりません。
最初の返信が出たのは、着手から3週間後です。
試しに「今週の回収は金曜でお願いします」というメールを流してみました。返ってきたのは、日付の変更を承知した旨の2段落の文面と、その下に並んだ抽出の結果です。施設名、回収日、変更前の曜日。3つとも合っていました。
担当者の2名に見せたときの反応も良く、うち1名は「これなら来週から使えますね」と言っています。
この時点では、モデルの選び方を間違えたという感覚はまったくありませんでした。
ここまでが、LLM比較の教科書どおりの整理です。系統ごとの傾向を押さえ、10の軸で並べ、目的から絞り込む。候補を3つまで減らすには、この手順で足ります。
この記事の後半で扱うのは、その先です。同じ入力を3回投げたときに、3回とも同じ形で返ってくるか。この列は、どの比較表にも載っていません。
② 同じメールを3回投げると、3回とも違う形で返ってきた
ところが、抽出の結果を検証しはじめると、様子がおかしくなってきました。
まったく同じメールを3回投げます。「白衣のサイズをMからLに交換したい」という、品目が1件しか出てこないメールです。返信の文面は、3回とも表現が違いました。文面については、それでかまいません。むしろ毎回おなじ挨拶文が返るほうが不自然です。
問題は、その下に出た抽出結果でした。 品目は1件しかないのに、3回のうち1回は2件になり、1回は3件になります。枚数の入っていない回もありました。
言い方を変えたメールを並べて、検証セット(動作を確かめるための例文集)を作りました。「金曜にずらして」「金曜でお願いします」「木曜は無理になりました」のように、依頼の中身は同じで言い回しだけを変えたものです。全部で42件あります。通してみると、抽出の失敗は42件のうち十数件で出ました。
品名を寄せる処理では、別の不具合が起きました。10件をまとめて投げる処理(バッチ処理)では、返ってくるまでに1回あたり26秒かかります。担当者は返信の下書きが出るまで画面の前で待つので、26秒は長すぎました。そのうえ、カタカナが記号に化けることがありました。「ガーゼケット」が「〒〳ゼケット」になって返ってきています。
もうひとつ、返す形の指定にも不備がありました。枚数にも日付にも当てはまらない数字用に、何を入れてもよい数値欄を1つ空けておいたところ、そこに桁の大きな数が入って返ってきます。
③ 気づいたのは、壊れる場所が片側に偏っていたときでした

最初に疑ったのは、指示文の書き方です。長い指示文を短く書き直しました。抽出の失敗は減りましたが、消えませんでした。
次に疑ったのは、返す形の指定です。何を入れてもよい数値欄を削り、選べる値をあらかじめ列挙しました。桁の大きな数は出なくなりましたが、品目の件数はまだ揺れます。
そこで、失敗した回を検証セットの上で分類してみました。すると、はっきり偏っていました。返信の文面で困った回は0件で、失敗はすべて抽出と品名寄せに集まっていました。
同じモデルに、同じ設定で、正反対のことを頼んでいたわけです。文面には毎回ちがう表現を期待し、抽出には毎回おなじ形を期待していました。
ここで、「モデルが弱いのではなく、1つのモデルに逆の要求をしていた」という見方に変わりました。
④ 原因を1件に絞る

思い当たることは、いくつもあります。指示文が長かったこと、返す形の指定が緩かったこと、出力(モデルから返る結果)のばらつき幅を決める「温度」という設定を、初期設定の0.7のまま動かしていなかったこと。
ただ、原因を絞ると1件でした。
LLMを賢さの順位で比較して、業務の名前ごとに割り当てていたこと。
役割の分け方が、はじめから業務の名前になっていました。返信を書く、項目を抜き出す、品名を寄せる。3件に分けてはいたのですが、どれも「届いたメールを読んで何かを返す仕事」なので、賢いモデル1つに寄せても筋が通ってしまいます。
実際、いちど3件を2件に減らしています。項目を抜き出す処理と品名を寄せる処理は、どちらもメールから値を取り出す仕事なので、まとめてよいと判断したからです。減らしても、抽出のゆれは直りませんでした。
業務の名前は、モデルに何を期待しているかを言っていません。分け方の軸そのものが、比較の役に立たない軸でした。
⑤ 直したのは、軸1本だけ

やったことは、役割の分け方を「業務の名前」から「出力が毎回おなじでなければ困るか」に変えることだけです。
その軸で見ると、別のモデルに切り出すべき役割は1件でした。品名を社内の品目名に寄せる処理です。ここは、同じ品名を投げたら同じ品目に寄ってくれないと、管理表が壊れます。
切り出した役割にだけ、次の4件を当てました。一世代前の軽い型番を指定すること。温度を0にすること。モデルには答えを出す前に考えを書き出させる手順があるので、その分量をゼロにすること。そして返す形を、選べる値まで含めて固定することです。
賢いモデルは、返信の文面のほうに残しました。
ただ、同じ軸で見ると、抽出も「毎回おなじが要る」という条件に当てはまります。抽出には、「今週の金曜」という書き方から実際の日付を割り出す判断が残るので、賢いモデルを使い続けました。モデルを替えたのは1件ですが、温度と返す形を締めたのは2件です。
抽出で最初に動かしたのは、温度です。既定の0.7から0.2に下げました。0.7のままだと、指定した形から外れた出力と、投げるたびに変わる出力の、両方が出ていたからです。品名寄せは0まで下げましたが、抽出は0.2で止めています。
次に、抜き出した値の受け皿を足しました。検証セットの失敗を1件ずつ見ていくと、モデルのゆれではない回が混じっていたからです。「この品目だけ最後に届けてほしい」。「来月から別の病棟に回してほしい」。「今回は本館の分だけでいい」。この3つには、受け皿になる項目がありませんでした。 近い項目に無理やり入るか、丸ごと落ちます。項目を3つ足しました。
もうひとつ、「今回は変更ありません」という返事を、失敗として数えていたことも分かりました。抽出が空で返るのが正しい場面なのに、読み取れなかった扱いにしていたからです。空の結果を、正当な「変更なし」として通すように直しました。
書き足したのは、役割名に応じて型番を返すだけの関数(コンピューターにさせる処理をひとまとまりにしたもの)です。45行しかなく、それを確かめるテストは49行と長くなりました。新しく作った画面は1つもありません。
⑥ あとで知った ── 「仕事が終わる一番小さいモデルを選ぶ」

しばらくして、LLMで実際に作ってきた1年ぶんの知見を、6名の実務者が共著でまとめた文書を読み、手が止まりました。applied-llms.org という文書で、書いたのは Eugene Yan、Bryan Bischof、Charles Frye、Hamel Husain、Jason Liu、Shreya Shankar の6名です。
そこに、そのままの見出しがありました。「Choose the smallest model that gets the job done」。仕事が終わる一番小さいモデルを選ぶ、という意味です。
書き出しは、次の一文です。「When working on a new application, it's tempting to use the biggest, most powerful model available」。新しく作るときは一番大きく強いモデルを使いたくなる、と最初に認めています。
そのうえで、次の一文が続きます。「A carefully crafted workflow using a smaller model can often match, or even surpass, the output quality of a single large model, while being faster and cheaper」。小さいモデルで丁寧に組んだ手順は、大きいモデル1つの出力品質に並ぶか、上回ることがある、という趣旨です。そして、一番小さいモデルを選べるのは、毎回おなじが要る処理を先に切り分けたときだけです。切り分けの軸が先で、モデルの大小はそのあとに来ます。
新しい理屈は、ひとつも要りませんでした。
⑦ 何が変わって、何を代償に払ったか

別のモデルに切り出した品名寄せでは、処理時間と出力の安定性という2つの指標が改善しました。10件をまとめて投げたときの時間が、1回あたり26秒から5秒になっています。考えを書き出させる手順をゼロにしたぶんです。そして同じ入力を3回投げると、3回とも完全に同じ出力が返るようになりました。品名寄せ用に用意した30件は、30件とも通っています。
抽出のほうも、言い回しを変えた42件で測り直しました。42件が42件とも通っています。 依頼の中身は同じで言い方だけを散らした検証セットなので、書きぶりが変わっても落ちなくなりました。
最後まで残った抽出漏れは1件です。「今週は無理なんですが、白衣とシーツとバスタオルと枕カバーをまとめてお願いします」というメールでした。日付の話と品目の列挙が同じ文に入ると、品目が4つとも消えます。指示文に、この形の例を1件だけ足しました。そのうえで同じメールを3回続けて投げて、3回とも品目が4つ揃っています。
ただ、代償があります。4件書いておきます。
1件目。文字化けは消えませんでした。 記号への化けは頻度が下がっただけで、ゼロにはなっていません。仕方がないので、返ってきた品目名に記号らしい文字が混じっていないかを見て、混じっていたら投げ直す処理を12行足しました。
2件目。型番が2つになり、片方の検証が漏れるようになりました。 管理画面には切り替えの欄がなく、軽いほうの型番はプログラム内に直接書かれたままです。新しい型番が出たとき、賢いほうだけ差し替えて、軽いほうを試し忘れます。
3件目。管理画面で選んだ型番が、一度も効いていなかったと分かりました。 初期化の処理(利用開始時に必要な準備をする処理)が、管理画面の設定を読まずに固定の型番を使っていたからです。画面上は選べていたので、誰も気づきません。モデルを選ぶ処理を1か所にまとめたときに、はじめて見える形になりました。払った代償は、それまで画面でモデルを選び直していた時間です。先に軸を決めていれば、払わずに済みました。
4件目。抽出で受け付けない依頼の種類を、決めて残しました。 「午前だけ回収して、午後は入れないでほしい」のような、途中を空ける依頼です。ここに応えさせると、ほかの項目の精度が落ちるので、受け付けないほうを選びました。代わりに確かめたのは、勝手に時間を書き換えないことだけです。3回投げて、3回とも回収の時間帯は元のまま返りました。担当者が手で埋める欄が、1つ残った形です。
⑧ 現場でLLMを比較するなら、この4つの問い

処理ごとにモデルを比較するとき、使っているのはこの表だけです。
1. 同じ入力に、毎回おなじ出力が要るか。要るなら、温度を下げ、返す形を固定し、受け皿の項目を用意します。要らないなら、賢い側のモデルでかまいません。
2. 返す形が決まっているか。決まっているなら、選べる値まで列挙して余白を消します。決まっていないなら、文章のまま返してよい。
3. まとめて処理できるか。できるなら、10件ずつ束ねて、考えを書き出させる手順を切ります。できないなら、1件ずつ投げます。
4. 間違えたら、人の目に触れるか。触れないなら、人の確認を残します。触れるなら、任せてよい。
いちばん効くのは1行目です。同じ入力に毎回おなじ出力が返ることは、賢いモデルを選ぶだけでは実現できません。 決まるのは温度と、返す形の指定と、考えを書き出させる手順の有無だからです。モデルを小さいほうに替えるかどうかは、そのあとの話です。
逆に、文章を書かせる処理では、この3つを締めるほど文面が硬くなります。同じ設定を全部の処理に適用すると、文章作成か抽出のどちらかの品質が必ず下がります。
この見方は、扱っている品物には依存しません。白衣でも、部品でも、注文書でも同じです。
ここからは余談です。読み飛ばしても、この記事の結論には影響ありません。ここまでのモデル選びで使った同じ軸は、コードを書かせる道具を選ぶときにも当てはまるので、並べておきます。使い分けている3つを、性能の順位ではなく手の入り方で並べます。ここでいう手の入り方とは、指示から外れたときの補い方や、人が途中で直せるかどうかです。ここに挙げるのは、普段使っているものだけです。
その前に、Claude Code、Codex、Antigravityが自分をどう説明しているかを見ておきます。公式サイトの一番上に出てくる一文が、そのまま各社の名乗りです。
Claude Code は、使える場所を並べています。ターミナル(文字で命令を入力する操作画面)、IDE(コードを書く・動かす機能をまとめた開発環境)、Slack、ウェブ。

Codex は、置き場所を1つに絞っています。ChatGPT の中で使える、という言い方です。

Antigravity は、道具ではなく基盤だと名乗っています。複数のエージェント(人の指示を受け、自分で手順を組み立てて作業を進めるAI)を並べて動かす司令台、という説明です。

(画面は各社の公式サイト。上から Claude Code、Codex、Google Antigravity。2026年8月10日時点のものです)
3つとも、答えているのはどこから使えるかです。指示から外れたときにどう振る舞うかは、どのサイトにも書いてありません。選ぶときに効いたのは、指示から外れたときの振る舞いでした。
そこで、公表されている説明と、使ってみた印象を、並べて置きます。
| 公式サイトの説明 | 使ってみた印象 | 向く段 | |
|---|---|---|---|
| Claude Code | ターミナル・IDE・Slack・ウェブから、コードベース(プロジェクトのコード一式)上で直接作業できる | 指示どおりに動かないと分かると、別の手を足してでも動く状態を守ろうとする | まだ形が決まっていないもの。企画を形にしていく段 |
| Codex | ChatGPT の中で使えるコーディングエージェント | 仕様に書いていないことはしない。 余計な補いが出ない | 形が決まっているもの。決めた仕様どおりに落とす段 |
| Antigravity | 複数のエージェントを並べて動かす、次世代のエージェント基盤 | コードと文書を見比べながら進められる。 簡単な直しも、仕様を書いた文書の手入れも、その場で自分の手で入る | 見た目を起こす段。そして、考え方を決めて仕様の文書に落としていく段 |
どれが優れているか、という表ではありません。動く状態を守るための補いは、仕様どおりの再現を崩します。 逆に、補わない道具に企画から任せると、決めていないところで止まります。
処理ごとにモデルを選ぶときと、まったく同じ分かれ目です。毎回おなじ出力が必要な処理では、補ってくれることが邪魔になります。
Antigravityだけ、軸がずれて見えるかもしれません。Antigravityを選ぶときに効いているのは、補うかどうかではなく、人の目と手が、途中に入れるかどうかです。見た目を決めていく段では、正解を先に言葉で渡せません。見て、直して、また見る。その回数がそのまま速さになります。
同じことが、仕様を書いた文書にも当てはまります。仕様は、書き上げてから渡すものではなく、手を入れ続けるものです。文書とコードを並べて見られると、決めたことと動いているものがずれた瞬間に気づけます。
3つの道具を並べ直すと、順番になります。考え方を決めて仕様の文書にするところ、まだ形の決まっていないものを形にするところ、決まった仕様どおりに落とすところ。 補う道具を仕様の再現に使うと崩れ、補わない道具を企画に使うと止まる、というだけの話です。
⑨ この比較の軸が効き続ける理由

モデルが賢くなっても、この軸は変わらないと考えています。
賢さで解けるのは、書きぶりと判断の部分だけだからです。同じ入力に同じ出力を返すかどうかは、賢さの外側で決まります。温度をどこに置くか、返す形をどこまで固定するか、考えを書き出させる手順を持たせるかどうか。ここは型番が新しくなっても、こちらが決める側に残り続けます。
もうひとつあります。比較表の順位は、3か月ほどで入れ替わります。ところが、「毎回おなじでなければ困る処理はどれか」は、事業の側の都合で決まるので、そう簡単には変わりません。担当者に聞いても、答えは「品目名と枚数だけは、いつも同じにしてほしい」でした。順位の話は一度も出ていません。
だから、順位を追いかけると数か月ごとに全部を並べ替えることになりますが、軸を持っていれば、差し替えるのは賢さが要る側のモデルだけで済みます。
このあたりの切り分けを実際の業務に落とす話は、生成AI導入支援のページに整理しています。どの処理にどのモデルを当てるかで迷っている工程があれば、こちらからご相談ください。
パン用の包丁は、いま引き出しの2段目に入っています。
出すのに引き出しを開けるのが面倒で、今朝も、よく切れるほうでパンを切りました。潰れたトーストを食べながら、これを書いています。
以上です。
▶ この記事のテーマを実務で相談する: 生成AIコンサルティング
- この話に出てくる事業
- ① 教科書どおりに、比較表の一番上のモデルを選んだ
- LLM(大規模言語モデル)とは
- LLMと生成AI・自然言語処理(NLP)の違い
- クローズドモデルとオープンウェイトモデルの違い
- クラウドLLMとローカルLLMの違い
- 主要LLMの比較表|系統ごとの傾向
- ベンチマークとリーダーボードの読み方
- LLMを比較する10の軸
- 目的別の選び方①|文章生成・コンテンツ制作
- 目的別の選び方②|業務効率化・社内活用
- 目的別の選び方③|開発・コード生成
- 目的別の選び方④|RAG(社内文書を参照させる)
- 目的別の選び方⑤|機密情報を扱う・社外に出せない
- ファインチューニングは必要か
- 注意点①|最新モデルが、必ず最適とは限らない
- 注意点②|ローカルLLMは運用コストまで含めて考える
- 注意点③|ハルシネーションと出力の正確性
- 注意点④|機密情報の取り扱い
- 比較の前に立ちはだかる、組織側の壁
- LLM比較のよくある質問
- ② 同じメールを3回投げると、3回とも違う形で返ってきた
- ③ 気づいたのは、壊れる場所が片側に偏っていたときでした
- ④ 原因を1件に絞る
- ⑤ 直したのは、軸1本だけ
- ⑥ あとで知った ── 「仕事が終わる一番小さいモデルを選ぶ」
- ⑦ 何が変わって、何を代償に払ったか
- ⑧ 現場でLLMを比較するなら、この4つの問い
- ⑨ この比較の軸が効き続ける理由


 柳田恒平

 AI・新規事業戦略大学

 Yasu


 Yuki Susai