

Service 08
RAG構築
社内GPT・ナレッジAIまで、同じチームで
WHAT IT IS
RAG構築とは
社内の文書やデータをAIが検索し、見つけた内容を根拠に答える仕組みを作ることです。「社内GPT」「社内チャットボット」と呼ばれるものの中身は、この仕組みです。
- 社内の文書やデータをAIが検索する。
- 見つけた内容を根拠に答える仕組みを作る。
CAUTION
「文書を入れるだけで、社内の質問に何でも答えるAIができます」は、注意が必要です
社内の知識には、表の数字、文書、組織や関係のつながりの3種類があり、探し方がそれぞれ違います。全部を1つの検索に入れると、数字の質問には推測で答え、古い版の文書を正解として返します。根拠をすぐに開けなければ、誤りに気づけず、やがて使われなくなります。
- 表の数字、文書、組織や関係のつながりは、それぞれ探し方が違う。一つの検索に入れると数字を推測し、古い版を正解にする。
- 知識の種類ごとに探し方を分け、根拠をすぐに開けるようにする。根拠を開けなければ誤りに気づけず、使われなくなる。
スクロールして続きを読む

WHY ARCHECO
質問の種類を見てから、探す場所を決めます
社内の質問には、文書を読めば分かるもの、表の数字を集計しないと分からないもの、人や案件の関係をたどらないと分からないものがあります。全部を同じ探し方で答えさせると、数字を推測で答えたり、古い文書を正解として返したりします。ARCHECOは質問の種類ごとに探し方を作り分け、答えには必ず元の文書を添えます。

知識の種類ごとに、検索を分けて作れる
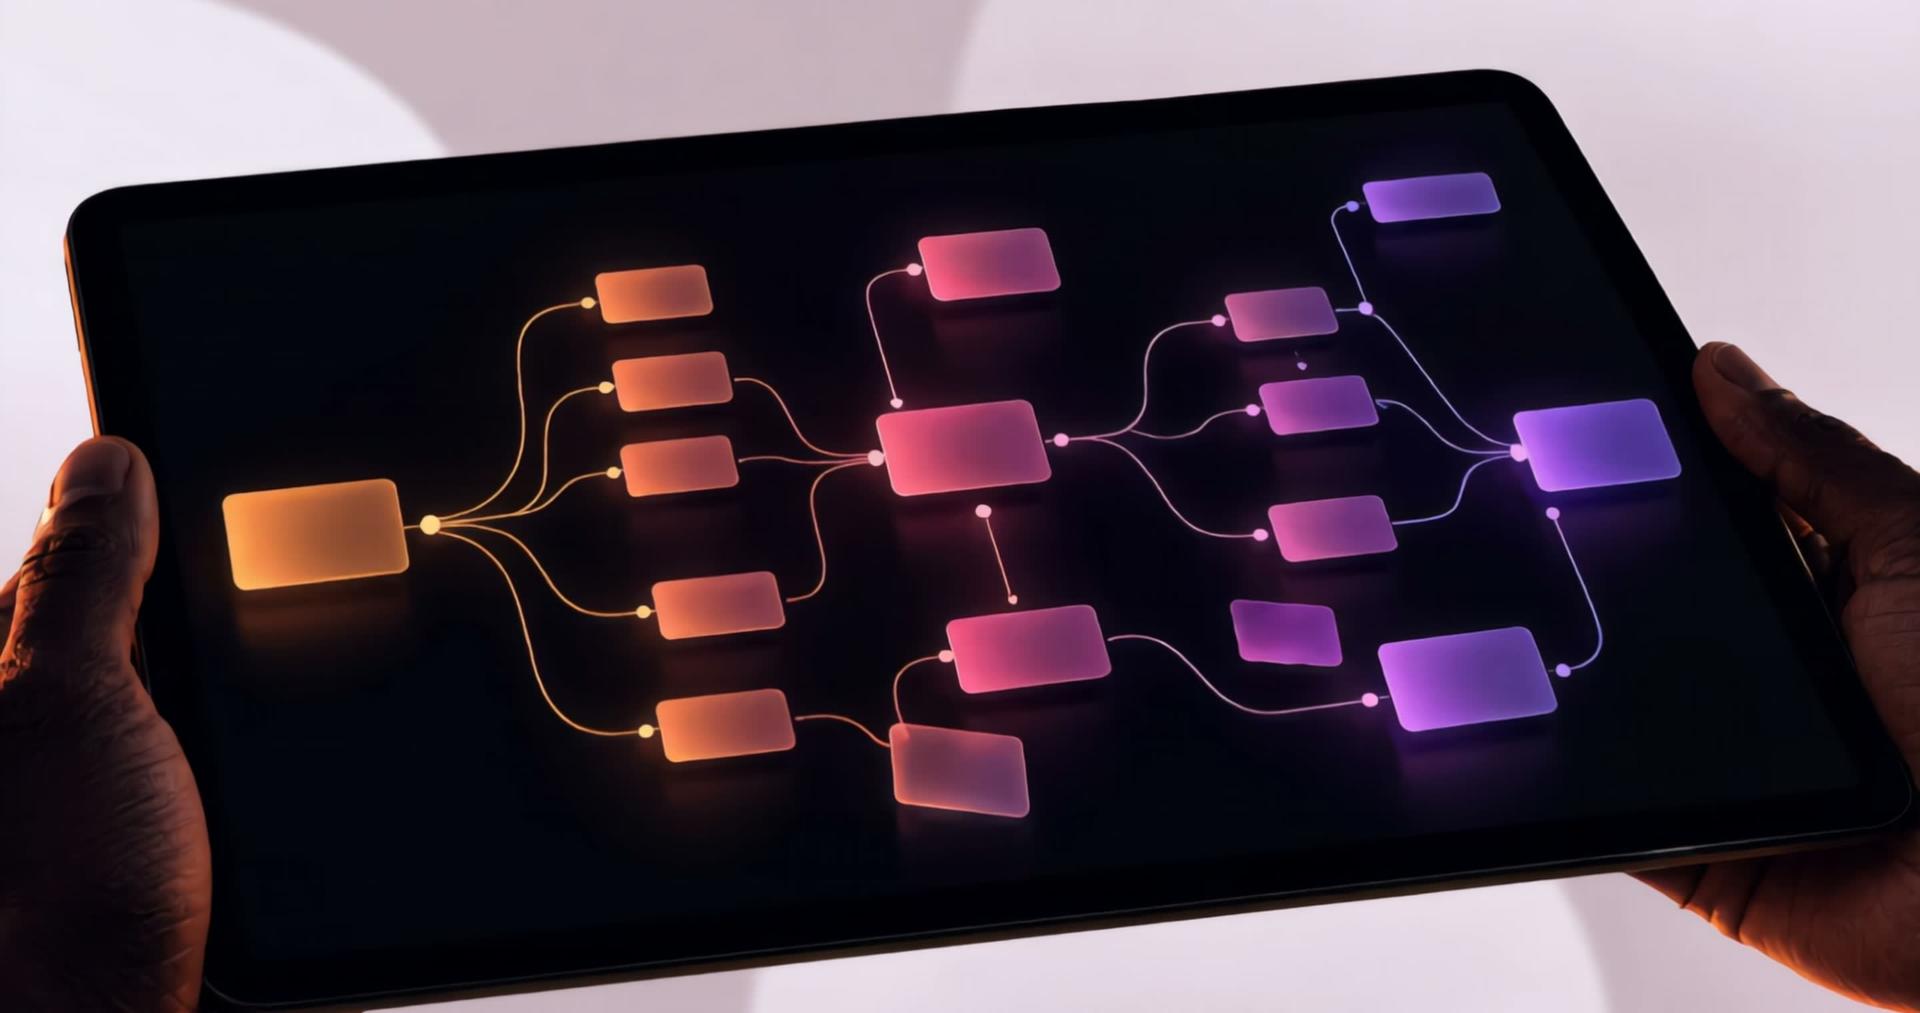
数字はデータベースへの問い合わせ、文書は意味とキーワードの検索、関係はつながりをたどる検索。質問の型に合わせて探し先を切り替え、検索が1つしかないために起きる誤答を、作りの段階で防ぎます。


自分たちのAIで、運用し続けている
文書もモデルも変わるので、精度は放っておくと落ちます。ARCHECOは自社のAIプロダクトを本番で運用し続けていて、精度を測り直して保つ運用まで引き受けます。作業まで任せたいときは、AIエージェントも同じチームで作ります。
SERVICE MENU
RAG構築の3つの型
いまどの段階にいるかで、頼むべき範囲が変わります。3つの型は排他ではなく、①から順に進めることも、既にRAGを持っている場合は③から入ることもできます。契約は1年以内のカスタマイズ開発受託が基本です。

文書の棚卸しから
設計先行型 RAG構築
文書の棚卸しから始め、AIが読める形への整え方と、精度を測る質問の一覧を渡します。
- 期間
- 文書の量と状態による

検索基盤と社内GPTを作る
構築型 RAG構築 (社内GPT開発まで)
検索の仕組みと、社員が使う画面を作ります。権限の制御と出典の表示まで含みます。
- 期間
- 要件と範囲による

作ったあとの精度と定着
運用改善型 RAG構築 (ナレッジ運用まで)
すでにRAGがある場合も、精度を測り直し、使われ続けるための運用を整えます。
- 期間
- 測定と改善を継続

Solution Flow
プロジェクトの進め方


01
STEP 01
社内データの棚卸しと構造化設計
対象となる社内文書・データソースを洗い出し、どこに何があり、更新は誰の担当かを明確にします。表のデータ・文書・組織のつながりでは検索の戦略が異なるため、種類ごとにチャンキング単位とメタデータ設計を分けて行います。ここを飛ばすと、更新されない古い文書を正解として返す事故につながります。

Method
データソースインベントリ
データ品質アセスメント
チャンキング戦略設計
メタデータスキーマ設計
Output
データ構造化計画書
メタデータ定義書
RAGアーキテクチャ設計と構築
ベクトルデータベースの選定、Embeddingモデルの評価を行い、問いの型に応じて参照先を切り替える検索パイプラインを設計します。数値の質問はデータベースへの問い合わせ、文書の質問はハイブリッド検索とリランキング、というように答え方を使い分けることで、検索が1つしかないために起きる誤答を防ぎます。
Method
ベクトルDB選定・構築
Embeddingモデル評価
検索パイプライン設計
リランキング実装
Output
RAGシステム
検索精度評価レポート
社内GPTインターフェース開発
構築したRAG基盤の上に、社員が業務の流れの中で自然文のまま聞ける対話型インターフェースを開発します。閲覧権限のない文書は検索結果にも出さないアクセス制御と、回答の根拠となる原文をワンクリックで開ける出典表示を実装します。
Method
チャットUI開発
権限管理実装
出典表示機能実装
Output
社内GPTアプリケーション
管理者ダッシュボード
精度改善とナレッジ運用設計
文書の更新やモデルの変更で精度は必ず落ちていくため、評価用の質問セットで定期的に測定し、誤りが出た質問をセットに追加していく改善サイクルを構築します。新規文書の自動取り込みと古い文書の失効フローまで含めて運用設計します。
Method
精度評価・改善サイクル設計
自動インデックス更新設計
利用ログ分析
Output
精度改善レポート
ナレッジ運用ガイドライン
利用状況分析ダッシュボード

CASE STUDIES
RAG構築の導入事例


COST
費用は、この4つで決まります
金額は、文書の量より、文書の状態と求める確かさで動きます。左に寄るほど小さく始められ、右に寄るほど作り込みが要ります。
対象の文書の量と状態
小少なく、整理されている
大多く、散らばっている
閲覧権限の複雑さ
小全員が同じものを見る
大部署や役職で分かれる
求める精度
小参考になればよい
大根拠つきで正確に
作り方
小既製のサービスを使う
大自前で組む
1作る
文書の整理、検索の仕組み、社員が使う画面。
2動かす
AIの利用料と、検索の基盤・クラウドの費用。使う量に応じて毎月かかります。
3直し続ける
質問の一覧で精度を測り直し、文書の更新に合わせて直す運用。
無料の診断で、どの文書から始めるか・どこを直せば精度が上がるか・概算をお返しします。
OUR APPROACH
RAG構築に対するARCHECOの考え方
RAG構築の考え方は、社内文書に答える仕組みを自社で作った経験に表れています。ブログ記事「RAGとは」の要点をまとめました。
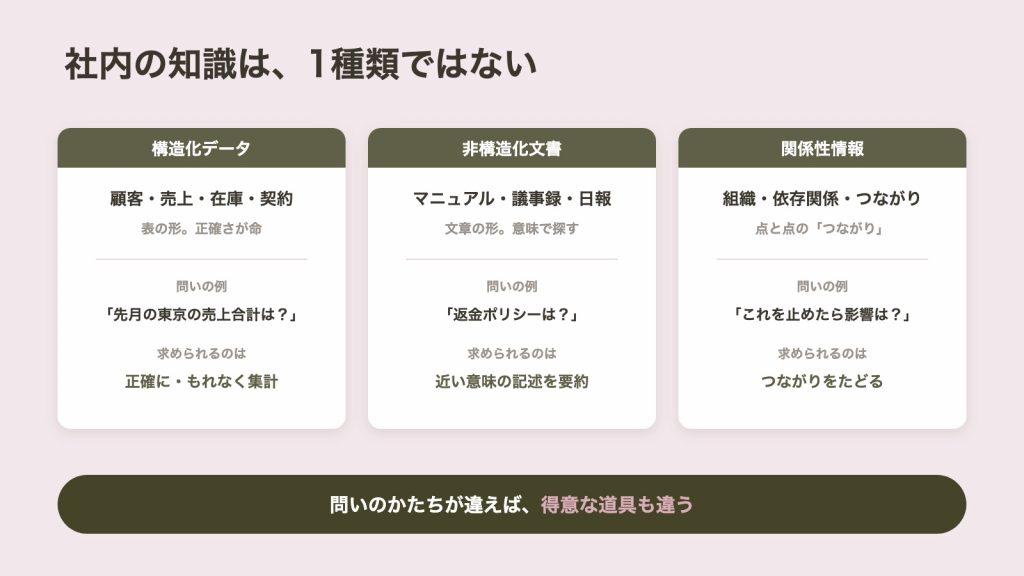
社内の知識は、文章を探す方法だけでは見つかりません。
文章向けの検索だけを改善しても、組織のつながりや数字の表には対応しきれません。探し方が1種類のままでは、回答の精度が伸び悩みます。
自社で作った仕組みでは、文章向けの検索だけでは「担当は誰か」「去年の数字は」に答えられませんでした。文章・組織のつながり・数字の表に応じて探し方を変えると、精度は再び上がりました。
だから、ARCHECOは
そのため、ARCHECOのRAG構築では、知識の種類ごとに探し方を組み合わせ、答えの根拠をその場で開けるようにします。


無料の社内AI診断
いまの社内文書が、AIで使える状態にあるかを無料で診断します。どの文書から入れるべきか、どこを直せば精度が上がるかを具体的にお返しします。

※弊社のリソース状況によってはお受け出来ないことがございます。
SERVICE MENU
RAG構築の3つの型
いまどの段階にいるかで、頼むべき範囲が変わります。3つの型は排他ではなく、①から順に進めることも、既にRAGを持っている場合は③から入ることもできます。契約は1年以内のカスタマイズ開発受託が基本です。
文書の棚卸しから
設計先行型 RAG構築
入れる前の設計で精度を決めます。対象となる社内文書・データソースを洗い出し、どこに何があり更新は誰の担当かを明確にします。表のデータ・文書・組織のつながりでは検索の戦略が異なるため、種類ごとにチャンキング単位とメタデータ設計を分けます。ここを飛ばすと、更新されない古い文書を正解として返す事故につながります。
- やること
- データソースの棚卸しと、データ品質の評価
- 文書の種類ごとのチャンキング戦略とメタデータスキーマの設計
- 評価用の質問セットの収集(構築前から始める)
- 成果物
- データ構造化計画書/メタデータ定義書/評価用質問セット
- 選べる契約
- 受託(準委任)
- 期間
- 対象文書の量と状態による
検索基盤と社内GPTを作る
構築型 RAG構築 (社内GPT開発まで)
ベクトルデータベースの選定とEmbeddingモデルの評価を行い、数値はデータベースへの問い合わせ、文書はハイブリッド検索とリランキング、というように問いの型に応じて参照先を切り替える検索パイプラインを設計します。その上に、社員が業務の流れの中で自然文のまま聞ける社内GPTの画面を開発します。閲覧権限のない文書は検索結果にも出さず、根拠の原文をワンクリックで開ける出典表示を実装します。
- やること
- ベクトルDB選定・構築、Embeddingモデル評価、検索パイプライン設計、リランキング実装
- 権限管理と出典表示を備えたチャットUI(社内GPT)の開発
- 実業務の質問セットによる検索精度の評価
- 成果物
- RAGシステム/検索精度評価レポート/社内GPTアプリケーション/管理者ダッシュボード
- 選べる契約
- カスタマイズ開発受託(1年以内)
- 期間
- 要件と対象範囲による
作ったあとの精度と定着
運用改善型 RAG構築 (ナレッジ運用まで)
文書の更新やモデルの変更で精度は必ず落ちていくため、評価用の質問セットで定期的に測定し、誤りが出た質問をセットに追加していく改善サイクルを構築します。新規文書の自動取り込みと古い文書の失効フローまで含めて運用を設計し、利用ログから答えられなかった質問を拾って文書整備の優先順位に回します。既にRAGや社内GPTを持っていて精度が頭打ちの場合は、ここから入ります。
- やること
- 精度評価・改善サイクルの設計と定期測定
- 自動インデックス更新と、古い文書の失効フローの設計
- 利用ログ分析と、文書整備の優先順位付け
- 成果物
- 精度改善レポート/ナレッジ運用ガイドライン/利用状況分析ダッシュボード
- 選べる契約
- 受託(準委任)
- 期間
- 継続(測定と改善の周期を決めて回す)
CASE TYPES
RAG構築の実績(類型別)
自社プロダクトでのAI基盤の内製と、事業会社の社内文書を対象にしたRAG構築・社内GPT開発を行ってきました。守秘の範囲で、類型と支援範囲だけを並べています。
ABOUT RAG
RAG構築の方法:手順・費用・精度の上げ方
社内文書をAIに接続するRAGの構築を検討している方に向けて、仕組みと効果、どのくらいの資料から始められるか(PDF・表・図の扱い)、構築の方法と手順、使う道具、精度を上げる要因、費用の決まり方、内製と外注の判断、よくある失敗、依頼先の選び方、そして導入後に使われなくなる問題までを整理しました。
RAGの仕組み:社内文書を検索してから答える
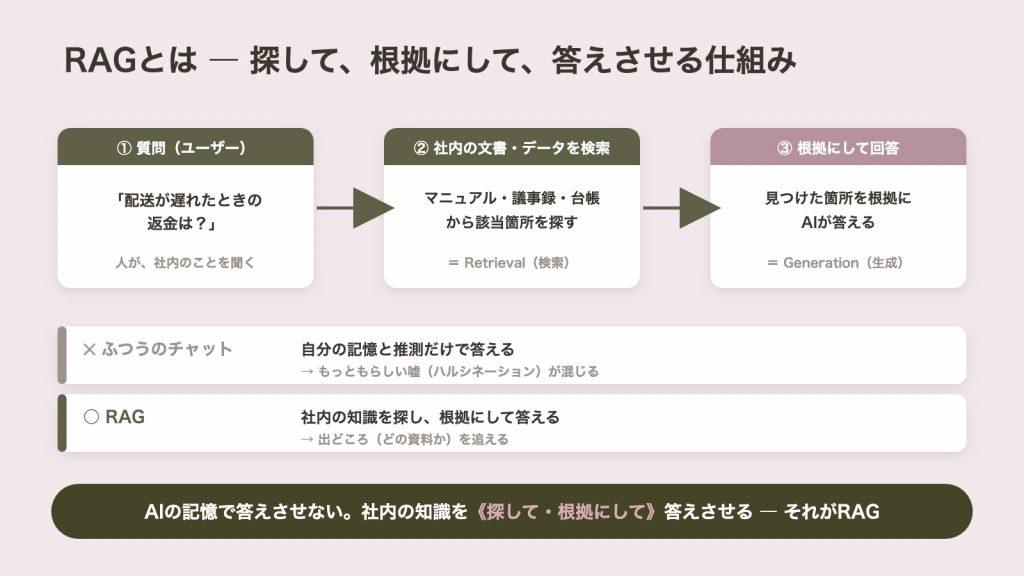
RAG(検索拡張生成)は、質問に答える前に社内文書を検索し、見つかった内容を根拠にAIが回答する仕組みです。社内の知識に答えられるAIを作る方法として、現在の標準になっています。RAG構築とは、この検索と生成のつながりを、自社の文書と業務に合わせて設計し組み上げることです。
- RAGはモデルの外にある文書を更新して知識を新しくします。回答のたびに資料を渡すので、知識の更新のためにモデルを学習し直す必要はありません。
- 質問に関係する文書の断片を検索で集め、それを材料にAIが回答を組み立てます。根拠の文書を示すことで、人が回答を検証できます。
- 追加学習はモデル自体を変え、口調や形式を学ばせる方法です。社内文書への回答にはまずRAGを使い、必要に応じて併用できます。
仕組み:検索してから答える
流れは2段です。質問に関係する文書の断片を検索で集め、それを材料にAIが回答を組み立てる。AI自体に知識を覚えさせるのではなく、答えるたびに資料を渡す方式なので、文書を更新すれば回答も新しくなります。この「知識の更新が文書の更新で済む」性質が、業務利用でRAGが選ばれる理由です。
ファインチューニングとの違い
ファインチューニングはモデル自体を追加学習させる方法で、口調や形式の学習には向きますが、事実知識の追加には不向きで、更新のたびに再学習が要ります。社内文書に答えさせる用途なら、まずRAGが正解です。両者は対立ではなく併用もできますが、順序は常にRAGが先です。
なぜ社内AIの標準になったか
生成AIの一般知識は業務では役に立たず、業務の答えは社内文書にあるからです。加えて、回答の根拠となった文書を示せるため、ハルシネーション(もっともらしい誤答)を人が検証できる。精度と検証可能性の両方を実務水準に引き上げたのがRAGです。
RAG構築が向くケース、向かないケース
向くのは、答えの根拠になる文書が社内にあり、その文書が更新され続け、回答に出典が要る業務です。規程やマニュアルへの問い合わせ対応が典型で、大量の文書から該当箇所を探す仕事ほど効きます。向かないのは、参照元が無く推論や創作が中心の仕事、特定の口調の再現が目的の仕事、数件のルールで完結する仕事で、これらはRAGを作っても効果が出ません。ARCHECOは、対象業務の答えが文書の中にあるかを診断の最初に確かめ、無い業務はRAG構築の対象から外して別の手段を提案します。
RAG構築で得られる効果
効果は大きく4つです。社員が資料を探す時間が減ること。総務・情報システム・サポートに繰り返し届く同じ問い合わせを、一次対応で受けられること。特定の人しか知らなかった手順や判断の根拠を、文書として共有できること。回答に出典が付くので、誤りを人がすぐに確かめられること。ARCHECOは効果を、根拠付きで答えられた質問の数と、答えられなかった質問がどれだけ減ったかで測ります。
社内GPT・社内チャットボットとRAG構築
「社内GPTを入れたい」「社内チャットボットを入れたい」という相談の中身は、多くの場合RAGの話です。社内GPTは社員が使う対話画面のことで、RAGはその裏で社内文書を検索して根拠を作る仕組みです。呼び名が違うだけで、社内の質問に答えるAIの中核はここで説明している仕組みそのものです。
- FAQ型は想定問答、シナリオ型は分岐を登録します。どちらも登録した質問に答える方式です。
- 生成AI型の社内GPTは社員が使う対話画面です。RAGはその裏で社内文書を検索し、回答の根拠を用意します。
- 同じRAG基盤を、規程の検索から議事録の要約、ドラフトの下書きへ広げられるように設計します。
社内チャットボットは3タイプに分かれる
社内チャットボットには、想定問答を登録するFAQ型、分岐を設計するシナリオ型、そして社内文書を検索して答える生成AI型があります。前の2つは「登録した質問」にしか答えられず、メンテナンスが続かず放置されるのが典型的な失敗です。文書を更新すれば回答が変わる生成AI型——その中身がRAGです。
RAG構築の代表的なユースケース
最も多いのは社内ナレッジの検索です。就業規則や社内規程の照会、製品・サービスのマニュアル検索、過去の提案資料や設計書の参照など、文書量が多く同じ問い合わせが繰り返し起きる業務で効果が出ます。部門別に見ると、人事・総務は規則や手続きの照会、営業は過去の提案書や製品資料の検索、製造・技術部門は設計書や不具合報告の参照、法務は契約書のひな形と過去の判断の確認に使うことが多いです。外向きでは、カスタマーサポートの一次回答やFAQの自動化に使われ、オペレーターが回答の根拠をすぐ確認できる形にすると対応が速くなります。ARCHECOは、入口がどの用途でも、同じRAG基盤を規程の検索から議事録の要約、ドラフトの下書きへ広げられるように設計します。
既製ツールを買うか、RAG基盤を構築するか
判断軸は3つです。対象が総務・情シスの定型問い合わせだけなら既製ツールで足ります。答えの根拠になる文書が頻繁に更新される、部署ごとに見せてよい文書が違う、問い合わせ対応の先で検索や要約にも広げたい——この3つのどれかに当てはまるなら、基盤として構築するほうが結局安くつきます。
問い合わせ削減で終わらせない
社内チャットボットの費用対効果を問い合わせ削減だけで測ると、たいてい投資に見合いません。同じRAG基盤が、規程の検索、議事録の要約、ドラフトの下書きへ広がって初めて回収線を越えます。入口はチャットボットでも、設計は基盤として行う。これがこのページ全体でお伝えしたいことです。
答えるだけでなく、作業まで任せる場合
検索して答えるだけでなく、答えをもとに申請書を下書きする、問い合わせの記録を起票する、別のシステムに登録するところまで任せたい場合は、RAGを道具の1つとして持つAIエージェントの設計になります。どこまでをAIに任せ、どこで人が承認するかの決め方は、AIエージェント開発のページで説明しています。
AIエージェント開発RAG構築はどのくらいの資料から始められるか:PDF・表・図の扱い
「文書が多すぎる」「整理されていない」は、RAG構築を始められない理由になりません。始める量は文書の総量ではなく、最初に答えさせたい質問で決まります。難しいのは量より形式で、PDF・表・図はそれぞれ扱いが違います。
- 一つの業務のよく聞かれる質問を集め、答えが載る文書だけから始めます。最新版が明確で、更新の担当が決まっていることが大切です。
- 文字として読めるPDFは文章を抽出し、スキャンPDFはOCRで文字に起こします。段組みの崩れや読み誤りがないか、結果を目で確かめます。
- 表の行と列の対応を保ちます。小さな表は行ごとに「項目名:値」に直し、数字を正確に答える必要がある表はデータベースへの問い合わせに回します。
- 図ごとの説明文と元の図をひも付けます。スライドは一枚ごとに区切り、各ページの題名を見出しとして使います。
最初は、1つの業務のよく聞かれる質問から
全社の文書を集めてから始める必要はありません。1つの業務で繰り返し聞かれる質問を集め、その答えが載っている文書だけを最初に入れます。文書の数より、更新の担当が決まっていて最新版がはっきりしていることのほうが大切です。答えられなかった質問を見ながら、対象の文書を足していきます。
PDFとスキャンした紙の文書
文字として読めるPDFは、そのまま文章を取り出せます。ただし段組み、ページの上下に入る見出しやページ番号、ページをまたぐ文章は崩れやすく、取り出した結果を目で確かめる工程が要ります。紙をスキャンしたPDFは画像なので、文字認識(OCR)で文字に起こしてから入れます。手書きや古い書式は読み誤りが残るため、よく使う文書から優先して確かめます。
表とExcel
表を普通の文章と同じように切って入れると、行と列の対応が崩れ、数字を取り違えます。料金表や在庫表のように数字を正確に答える必要がある表は、文章の検索ではなくデータベースへの問い合わせに回します。規程の中の小さな表は、行ごとに「項目名:値」の文章に直してから入れると、検索で拾いやすくなります。
図・画像・スライド
図の中の情報は、そのままでは検索に引っかかりません。画像を読めるAIで図ごとの説明文を作り、説明文と元の図をひも付けて入れます。回答には説明文だけでなく元の図を添えると、利用者が自分で確かめられます。スライドは1枚ごとに区切り、各ページの題名を見出しとして使うと、検索で拾いやすくなります。
共有フォルダ・クラウドの保存先・社内システムに散らばっている場合
保存先ごとに、取り込み方と更新を反映する方法が変わります。ファイル共有のサービスや社内Wikiには、多くの場合つなぐ手段が用意されています。どこから取り込むかより先に、同じ文書の旧版がどこに残っているかを洗い出してください。旧版が混ざると、AIが古い内容を正解として答えます。
RAG構築の手順
構築は5工程です。技術要素の名前は難しく見えますが、やっていることは「文書を検索できる形に整えて、AIに渡す」の一本道です。
- 重複・旧版・誤りを整理し、よく使う領域に対象を絞ります。
- 文書の種類ごとに、意味が切れない分割単位を実データで調整します。
- 検索結果をAIに渡し、根拠が無ければ無いと答える設計にします。
- 評価用の質問セットは構築前から集め、実際の業務の質問で回答の正しさを測ります。
1. データの選定と整備
どの文書を対象にするかを決め、重複・旧版・誤りを整理します。構築の成否はこの工程でほぼ決まります。ゴミ文書を入れれば、検索がゴミを見つけてAIがゴミを根拠に答えます。全文書を一括投入するのではなく、よく使う領域から絞って始めるのが定石です。
2. 文書の分割(チャンク化)
文書を検索しやすい単位に切ります。切り方が粗いと関係ない部分まで混ざり、細かすぎると文脈が切れて意味が失われます。文書の種類(規程・議事録・マニュアル)ごとに適切な切り方が違うため、ここは一律の設定ではなく実データでの調整が要ります。
3. ベクトル化とデータベース格納
文書の断片を、意味の近さで検索できる形式(ベクトル)に変換して格納します。ここはツールが担う部分で、選定の論点は精度よりも、権限管理・日本語対応・運用コストです。
4. 検索とAIの接続・プロンプト設計
検索結果をどう並べ、AIにどう渡すかを設計します。「見つかった文書だけを根拠に答え、無ければ無いと言う」という指示の作り込みが、実用の信頼性を決めます。分からないときに分からないと言えるAIは、設計しないと生まれません。
5. 評価と改善
実際の業務の質問を集めたテストセットで、回答の正しさを測ります。体感での「良くなった気がする」は評価ではありません。質問セットは構築前から集め始めてください。現場から集まる「本当に聞きたいこと」が、そのまま設計の仕様になります。
期間を左右するもの
期間は工程の数より、どこでつまずくかで決まります。長引く原因は、文書の整備(旧版の整理や表の作り直し)、閲覧権限の設計、既存の社内システムとの接続、評価の合格線をだれが決めるかの合意、社内のセキュリティ審査の5つにほぼ集中します。ARCHECOは着手前に、この5つのどれが重いかを見立て、重いものから先に手を付けます。
RAG構築の方法:ノーコード/クラウドAPI/自前開発
構築の方法は3つに分かれます。文書を載せるだけで動く既製・ノーコードのサービス、クラウドのマネージド検索とLLMのAPIを開発フレームワークでつなぐ方法、検索の各段を自前で設計して組む方法です。どれが正しいかは、要件の固まり具合と、権限・既存システム接続の複雑さで決まります。
- 定型の問い合わせで、権限と回答形式が単純なら、既製サービスで足りることがあります。
- APIで提供される検索とAIをつなぎます。文書の切り方、検索結果の並べ方、回答への指示は自分で設計します。
- 複雑な権限や既存システムとの接続、数値・関係性の質問に合わせ、検索の各段や参照先の切り替えを設計します。
ノーコード・既製サービスで小さく試す
管理画面から文書を載せるだけでチャットが動くサービスは、初期費用と立ち上がりの速さで優れます。対象が定型の問い合わせに限られ、権限が単純で、回答形式に固有の要件が無いなら、ここで足りることは多いです。ARCHECOは、要件が固まっていない段階では既製で試して輪郭を掴むことを勧めています。試した結果の「答えられなかった質問」が、そのまま次の構成の仕様になります。
クラウドAPIと開発フレームワークで組む
クラウド各社のマネージドな検索サービスとLLMのAPIを、開発フレームワークでつなぐ方法です。既製より自由度が高く、自前開発より速い。チャンクの切り方、検索結果の並べ方、プロンプトの作り込みは自分で設計することになり、ここが精度の差になります。ARCHECOの構築はおもにこの形で、ベクトルデータベースの選定とEmbeddingモデルの評価を要件ごとに行います。
自前で検索パイプラインを設計する
権限管理が複雑、既存の業務システムに接続する、数値や関係性の質問にも答える——こうした要件があると、既製の検索ひとつでは足りません。ARCHECOは、数値はデータベースへの問い合わせ、文書はハイブリッド検索とリランキング、関係性はグラフ探索というように、問いの型に応じて参照先を切り替える検索パイプラインを設計します。検索が1つしかないために起きる誤答を防ぐのが、自前で組む理由です。
よく使われる道具:LangChain・LlamaIndexとクラウドのRAGサービス
開発の枠組みとしてはLangChainとLlamaIndexがよく使われ、画面操作で組む場合はDifyなどがあります。クラウドでは、Azure AI Search、Amazon Bedrockのナレッジベース、Google CloudのVertex AI Searchが、文書の取り込みと検索をまとめて提供しています。ベクトルデータベースは、すでに使っているPostgreSQLに拡張機能(pgvector)を足す方法から、専用のサービスまで選べます。集めた候補を読み直して並べ替えるリランキングは、多くの道具で後から足せます。ARCHECOは道具を先に決めず、権限・データの置き場所・社内ですでに使っているクラウドに合うものを選びます。
RAG構築の精度を決める要因
「RAGの精度が出ない」という相談の原因は、ほぼこの3つに帰着します。モデルの賢さは、たいてい犯人ではありません。
- 古い・矛盾した・未記載の文書は、AIでは直せません。まず根拠となる文書を整えます。
- 型番・固有名詞・数値を拾うため、意味の近さによる検索にキーワード検索を組み合わせます。
- 複数文書の比較や集計など、実際の質問の型に応じた追加設計が必要です。
- ハイブリッド検索、候補の並べ替え、質問の書き換え、絞り込み、文書の切り直しを、評価用の質問セットで測ります。
データの質:検索は文書より賢くならない
回答の上限は文書の質で決まります。文書が古い・矛盾している・そもそも書かれていない場合、AIはそれを直せません。精度改善の投資先として、モデル変更よりも文書の整備のほうが効く場面は非常に多いです。
検索の方式:意味検索だけでは足りない
標準のベクトル検索(意味の近さ)は、型番・固有名詞・数値の検索が苦手です。業務の質問にはこれらが頻出するため、キーワード検索と組み合わせるハイブリッド化が実用の定番になっています。「似た話」ではなく「その話」を見つけられるかが、業務利用の分かれ目です。
質問の型:一問一答以外への対応
「AとBの違いは」「最新の版はどれか」のような、複数文書の比較や集計が要る質問は、単純な検索では答えられません。利用者の質問の型を観察して、多い型に対応する追加設計を入れる。導入後の改善は、この地道な繰り返しです。
精度を上げる打ち手の順番
ハイブリッド検索、リランキング(集めた候補を専用モデルで読み直して並べ替える)、曖昧な質問の書き換え、部署や日付での絞り込み、チャンクの切り直し。打ち手はこの5つが定番で、一度に全部入れる必要はありません。ARCHECOは、候補を集める工程と絞る工程を分けて考え、まず動いている文書検索そのものを強くしてから、別のデータベースやモデルを足します。効果は評価用の質問セットで測り、体感では判断しません。
RAG構築の費用は、何で決まるか
「RAG構築の料金はいくらか」は検索でもよく聞かれる質問ですが、金額の答えは条件次第でしか出せません。金額を動かす変数と、内訳、契約の形、削ってよいものの順に並べます。
- 文書の量と状態、閲覧権限、求める精度、既製サービスか自前構築かで費用が変わります。
- 範囲を絞っても、文書整備と評価は削りません。ここを削ると精度が出ず、作り直しになります。
- 構築後も文書更新・精度監視・API利用の費用がかかります。
- 初回はよく使う領域に絞り、多言語対応や高度な分析画面などは後回しにします。
金額を動かす変数
対象文書の量と状態(整備が要るか)、権限管理の複雑さ(誰がどの文書を見てよいか)、求める精度水準、既製サービスを使うか自前で組むか。この4つでほぼ決まります。とくに文書の整備と権限は見積もりから漏れやすく、後から膨らむ典型です。
費用の内訳:何に払っているか
見積もりの内訳は、要件定義、設計、構築、評価・テスト、運用保守に分かれ、初期費用のほかにインフラとAIモデルの利用料が毎月かかります。人件費が中心なので、金額は関わる人の単価と工数で決まり、扱うデータの形式が増えるほど、専門分野の知識が要るほど工数は膨らみます。ARCHECOの見積もりで先に置くのは、文書の棚卸しと構造化、評価用の質問セットの2つです。ここに払わない構築は、あとから精度改善の名目で膨らみます。
契約形態で、費用の性質が変わる
準委任は工数に対して払う契約で、要件が動く前提の構築に向きます。請負は成果物に対して払う契約で、要件が固まっているほど有利ですが、変更のたびに追加費用の話になります。RAG構築は文書の状態を見てから設計が動くため、設計までは準委任、構築は範囲を固めて受託、という分け方が現実的です。ARCHECOは1年以内のカスタマイズ開発受託を基本に、事業フェーズに合わせて契約の形を選びます。
既製サービスか、自前構築か
社内QA用途なら既製のRAG搭載サービスで足りることが多く、自前構築が要るのは、権限・既存システム接続・回答形式に固有の要件がある場合です。順序としては、既製で試して要件の輪郭を掴んでから、足りない部分だけ自前化するのが安全です。最初から大きく作る判断は、要件が本当に固まっている場合に限られます。
運用にかかる費用
構築後も、文書の更新反映・精度の監視・API費用が毎月かかります。とくに文書のメンテナンス体制(誰が文書を直すのか)は費用というより組織の問題で、ここが決まっていないRAGは構築の半年後に古い回答を返し始めます。
費用を抑えるときに、削ってよいもの・いけないもの
削ってよいのは、最初のリリースの対象範囲と機能です。対象文書をよく使う領域に絞り、多言語対応や高度な分析画面は後回しにする。既存のフレームワークやテンプレートを使うのも効きます。削ってはいけないのは、文書の整備と評価です。ここを削ると精度が出ず、結局作り直しになります。ARCHECOは、全文書の一括投入ではなく、更新の担当が決まっている文書から始めることを勧めています。
RAG構築を内製するか、外注するか
RAG構築で最初に決める判断です。内製は初期費用が低くノウハウが社内に残る一方、立ち上がりが遅く、検索の設計経験が無いと精度で詰まります。外注は速く、専門家が設計しますが、追加開発のたびに費用がかかり、運用が他人任せになりがちです。どちらか一方ではなく、分担で考えます。
- 専門人材が社内にいない場合、設計と初期構築を外注する分担が選択肢になります。
- 文書更新と精度監視は社内で回します。文書を直すのは社内の人でなければ続きません。
- 精度評価の改善サイクル、新規文書の取り込み、古い文書の失効フローを運用手順として引き継ぎます。
内製が向くケース
社内にAI/MLの経験があるエンジニアが複数いて、仕様変更や機能追加が続くと分かっており、機密性の理由で外に出せない文書を扱う場合です。開発フレームワークとベクトルデータベースの構築経験、インフラの担当が揃っている必要があり、この3つが揃う企業はまだ多くありません。揃っていないまま内製に入ると、構築より前の文書整備で止まります。
外注が向くケース
専門人材が社内にいない、早くリリースしたい、まずPoCで効果を確かめてから本格導入を判断したい、構築後の保守と改善まで一括で頼みたい場合です。外注先を選ぶときは、RAG構築の実績、導入後の運用・改善の支援、精度が出なかったときの対応の3点を確かめます。
初期構築は外注、運用は内製にする
現実的な分担は、設計と初期構築を外注し、文書の更新と精度の監視を社内で回す形です。ARCHECOの構築は、この分担を前提にしています。精度評価の改善サイクルと、新規文書の自動取り込み・古い文書の失効フローを設計し、ナレッジ運用ガイドラインとして引き継ぎます。文書を直すのは社内の人でなければ続かないからです。
RAG構築のセキュリティと権限
社内文書を扱う以上、ここの設計を後回しにはできません。論点は3つです。
- 元の文書の閲覧権限を検索段階で尊重します。利用者が読めない文書は、回答を作る前に検索対象から外します。
- 文書とベクトルデータの保存先・国や地域、モデル提供元に学習利用されない契約かを構成選定時に確認します。
- 外部へ出せない要件がある場合は、オンプレミス・プライベートクラウド・ローカルLLMを検討します。
文書の閲覧権限を、回答にも引き継ぐ
人事評価や経営資料が、RAG経由で全社員に読める状態は事故です。元の文書の閲覧権限を検索段階で尊重する設計(利用者が読めない文書は検索対象から外す)が必須で、これは後付けが難しいため、最初の構成選定の条件に入れてください。
データの置き場所と契約
文書とベクトルデータがどこに保存され、モデル提供元に学習利用されない契約か。ここは生成AI導入全般と同じ論点ですが、RAGは機密文書そのものを預けるため、要求水準を一段上げて確認します。
クラウド型かオンプレ型か
エンタープライズ向けのクラウドAPIは、入力を学習に使わない契約と、契約者の領域で閉じた処理が前提で、一般向けの対話サービスとは設計が違います。それでも、法規制や社内ポリシーで外部クラウドに出せないデータ(顧客の金融情報、医療情報、特許に関わる技術文書)がある場合は、オンプレやプライベートクラウド、ローカルLLMが選択肢になります。費用と保守は増えますが、要件が最優先なら正当な判断です。ARCHECOは、データの保存先と保存される国・地域、学習利用の有無、アクセス制御の実装計画を、構成選定の条件として最初に確認します。
RAG構築でよくある失敗
技術の失敗より、進め方の失敗のほうが多く見られます。構築の段階で起きやすい4つを、ARCHECOの防ぎ方と並べます。導入した後に起きる問題は、次の節で扱います。
- 旧版や下書きを混ぜず、更新の担当が決まっている文書から始めます。
- 構築前に現場の実際の質問を集め、合格線を決めます。
- 閲覧権限は最初の構成選びの条件に入れます。後付けでは検索から作り直すことになります。
- モデルを替える前に、外した質問を一件ずつ開き、検索で正しい文書を拾えていたかを確かめます。
全部の文書を一度に入れる
旧版や下書きが混ざり、AIが古い内容を正解として返します。一度信頼を失うと、あとで精度を直しても使われません。ARCHECOは、更新の担当が決まっている文書から始めます。
評価用の質問を作らずに作り始める
何をもって「答えられた」とするかが決まっていないと、改善の効果が測れず、議論が感想の言い合いになります。ARCHECOは構築の前に現場から実際の質問を集め、合格線を先に決めます。
閲覧権限を後回しにする
試作では、全員が全部の文書を見られる状態で作りがちです。本番で権限を足そうとすると、検索の仕組みから作り直すことになります。ARCHECOは、権限を最初の構成選びの条件に入れます。
精度が出ない原因をモデルに求める
精度が出ないときにモデルを替えても、多くの場合は改善しません。原因はたいてい、文書の質、文書の切り方、検索の方式のどれかにあります。ARCHECOは答えを外した質問を1件ずつ見て、検索で正しい文書を拾えていたかから確かめます。
RAG構築の導入後の壁:使われなくなる理由
技術的に成功したRAGが、利用されずに止まる例は珍しくありません。検索上位の構築ガイドはここをほぼ書いていませんが、投資対効果を決めるのはこの部分です。
- よく聞かれる領域で精度を作り、答えられる範囲を明示して公開します。
- 問い合わせ窓口の一次対応をRAGへ寄せ、回答に根拠文書のリンクを付けて自走できる導線を作ります。
- 未回答ログを文書整備の優先順位へ回します。この循環の担当を決め、更新を続けます。
最初の誤答で信頼を失う
利用者は数回試して期待した答えが出ないと、戻ってきません。全社公開の前に、よく聞かれる領域で精度を作り込み、答えられる範囲を明示して出すこと。「何でも聞いて」と出して外すより、「この範囲は答えられる」と出して当てるほうが、利用は定着します。
聞く習慣は、勝手には生まれない
人に聞くほうが早い、という既存の習慣にRAGは負けます。定着した組織がやっているのは、問い合わせ窓口の一次対応をRAGに寄せる・回答に根拠文書のリンクを付けて二度目から自走できるようにする、といった導線の設計です。ツールの品質と同じくらい、導線が利用率を決めます。
答えられなかった質問が、改善の資産
答えられなかった質問のログは、どの文書が足りないかの一覧そのものです。これを文書整備の優先順位に回す循環を作ると、RAGは使うほど賢くなります。循環の担当が決まっていないRAGは、初期品質のまま劣化していきます。
RAG構築を依頼する会社の選び方
RAG構築は運用で精度が決まるため、会社選びで見るのは提案書の厚さではなく、精度を作って育てた経験があるかです。確かめる観点は4つです。
- AI開発一般ではなく、検索と評価の知見、精度を改善した経験を確かめます。
- モデルやデータベースの名前に加え、文書ごとの分割単位とメタデータ設計を聞きます。
- 納品後の調整・文書更新が契約に含まれるか、精度が出ない場合の改善手順と担当体制を確かめます。
- 小規模なPoCから段階的に広げられるか、閉域や入力を学習に使わない構成にも対応できるかを確認します。
RAG構築に特化した実績があるか
AI開発の実績一般ではなく、ベクトル検索・ハイブリッド検索・評価の知見と、精度を改善した経験があるかを見ます。業種や用途が近い導入実績があれば、要件のすり合わせが速くなります。ARCHECOは、自社プロダクトのAI基盤を本番運用しながら、事業会社の社内文書を対象にしたRAG構築と社内GPT開発を行ってきました。
技術構成を、具体的に説明できるか
使うLLM、Embeddingモデル、ベクトルデータベース、フレームワークを明示できるか。とくにチャンキング設計の方針を聞くと、技術力が分かります。「最適なものを使います」で終わる回答は避けてください。ARCHECOは、文書の種類ごとにチャンキング単位とメタデータ設計を分ける方針を、データ構造化計画書とメタデータ定義書の形で先に出します。
精度が出なかったときの対応と、運用の体制
納品後の精度チューニングと文書更新が契約に含まれるか、精度が出なかった場合の改善プロセスを説明できるか。「作って終わり」の会社は、ここで答えが曖昧になります。ARCHECOは、実業務の質問セットで測った検索精度評価レポートを成果物にし、誤りが出た質問をセットに追加する改善サイクルまで含めて設計します。
PoCから小さく始められるか
全量発注を求める会社より、小規模なPoCで効果を確かめてから段階的に広げる進め方を提示する会社を優先します。セキュリティは、閉域やローカルLLMに対応でき、入力を学習に使わない構成を組めるかを併せて確認します。ARCHECOでは、無料の社内AI診断で、どの文書から着手すべきか、どこを直せば精度が上がるかを先に見立ててから、範囲を決めます。
NEWS & BLOG
RAG構築の関連記事


SOLUTIONS
RAG構築で使う開発手法・契約モデル
このサービスで使う開発手法・契約モデル・技術方式です。

Hybrid Rag
「もっと賢いモデルに変える」のではなく「検索の型を正しい順番で強くする」ことで、頭打ちになった社内RAGの精度をもう一段引き上げます


Enterprise AI Platform
「AIツールを増やす」ことではなく「安全に一本化する」ことで、部門ごとに乱立したAI活用を、認証・コスト・利用ログが見える全社基盤に変えます
FAQ
RAG構築のよくある質問
ご相談の前によくいただく質問です。解決しない点はお気軽にお問い合わせください。

01
QUESTION
RAGとは何ですか?
RAG(検索拡張生成)は、質問に答える前に社内文書を検索し、見つかった内容を根拠にAIが回答を組み立てる仕組みです。AIに知識を覚えさせるのではなく、答えるたびに資料を渡す方式なので、文書を更新すれば回答も新しくなり、根拠となった文書を人が確認できます。社内の質問に答えるAIを作る方法として現在の標準で、「社内GPT」「社内チャットボット」と呼ばれるものの中核はこの仕組みです。ARCHECOは、社内の知識を数値・文書・関係性の3種類に分け、問いの型に応じて参照先を切り替える形でRAG構築を行います。
02
QUESTION
RAG構築の費用は何で決まりますか?
対象文書の量と状態(整備が要るか)、権限管理の複雑さ(誰がどの文書を見てよいか)、求める精度水準、既製サービスを使うか自前で組むか、の4つでほぼ決まります。内訳は要件定義・設計・構築・評価・運用保守に分かれ、初期費用のほかにインフラとAIモデルの利用料が毎月かかります。とくに文書の整備と権限は見積もりから漏れやすく、後から膨らむ典型です。ARCHECOは無料の社内AI診断で、どの文書から着手すべきか、どこを直せば精度が上がるかを見立ててから概算をお出しします。
03
QUESTION
RAGとファインチューニングの違いは何ですか?
RAGは文書を検索してAIに渡す方式で、ファインチューニングはモデル自体を追加学習させる方式です。ファインチューニングは口調や形式の学習には向きますが、事実知識の追加には不向きで、更新のたびに再学習が要ります。社内文書に答えさせる用途なら、まずRAGが正解です。両者は対立ではなく併用もできますが、順序は常にRAGが先で、ARCHECOもRAG構築で土台を作ってから必要に応じて追加の手段を検討します。
04
QUESTION
社内GPTとRAGは、何が違うのですか?
社内GPTは社員が使う対話画面のことで、RAGはその裏で正確な回答を作るための検索の仕組みです。社内GPTだけを導入してもAI自体の知識でしか答えられず、社内の最新情報には対応できません。RAG構築によって、社内文書を検索してから回答を生成する構成にすることで、初めて自社の情報に基づいた正確な回答が可能になります。
05
QUESTION
社内文書が整理されていなくても始められますか?
始められますが、全部を一度に入れるところからは始めません。よく参照され、更新の担当が決まっている文書から着手します。整理されていない文書をまとめて投入すると、古い版を正解として返すようになり、かえって信頼を失うからです。
06
QUESTION
導入後、検索の精度は落ちませんか?
何もしなければ落ちます。文書は更新され、モデルも変わるからです。評価用の質問セットを定期的に測定し、誤りが出た質問をセットに追加していく運用まで含めて設計します。
Plans
ARCHECOの契約モデル
受託開発(1年以内のカスタム開発)、代理出産型プロフィットシェア(ARCHECOが事業運営を主導、無償保証・サービス譲渡確約付き、2〜3年計画)、ジョイントベンチャー(双方が資本出資し事業体を共同設立、2〜3年計画)、スウェットエクイティ(労働力を株式として投下)。事業フェーズとリスク許容度に合わせて、最適な契約形態を設計します。どの契約を選んでも、事業を当てることへのこだわりは変わりません。
Plan 01
Customize Development
カスタマイズ開発受託
お好みのスタイルを何なりと
ARCHECOのソリューションライブラリと自律型AI開発エージェントを活用し、1年以内でカスタムシステムを構築・納品します。AI戦略策定からAgentic RAG構築、業務特化型プライベートSaaS開発、UX/UIデザインまで、事業に必要な全工程を一気通貫で実行します。

Plan 02
Surrogacy
代理出産
産みの苦しみ、請け負います
ARCHECOが事業の企画・開発・運営を主導し、2〜3年計画で事業を立ち上げます。無償保証、サービス譲渡確約、採用代行を含むリスク軽減策をセットで提示。事業が黒字化して初めてARCHECOの収益が発生するプロフィットシェア構造により、全員が事業の成功だけに集中します。

Plan 03
Joint Venture
ジョイントベンチャー
新たなお仕事ご一緒に
クライアント様とARCHECOが資本を出し合い、新たな事業体を共同設立します。双方からの人材出向・採用により、独立した組織として事業を推進。既存事業のルールや予算制度に縛られない「出島」として機能し、スタートアップと同等のスピードと柔軟性で意思決定を行います。

無料の社内AI診断
いまの社内文書が、AIで使える状態にあるかを無料で診断します。どの文書から入れるべきか、どこを直せば精度が上がるかを具体的にお返しします。
※弊社のリソース状況によってはお受け出来ないことがございます。